GBase 8a 集群级执行计划底层机制拆解
GBase 8a 是基于Share-Nothing架构的分布式MPP并行数据库,其SQL执行计划是数据库查询优化器对用户输入SQL语句,经过语法解析、语义校验、代价估算、路径择优后,生成的一套分布式并行执行方案,明确了SQL在集群各节点的数据扫描、关联、聚合、排序、数据重分布等全流程执行逻辑与资源调度方式。
执行计划是GBase 8a SQL性能调优的核心依据,核心作用是帮助运维、开发人员定位慢SQL瓶颈、识别低效执行逻辑、验证优化效果,规避全表扫描、无效数据迁移、冗余排序等性能问题。与传统单机数据库不同,GBase 8a执行计划分为集群层分布式计划和节点层单机执行计划,天然适配多节点并行计算、数据分片存储的集群特性。本文章重点描述集群层的执行计划。
GBase 8a执行计划架构原理
GBase 8a采用双层执行架构,执行计划对应分为两个层级,协同完成分布式查询:
集群层(GCluster)执行计划
调度集群,是整个集群的统一入口。主要负责从业务端接受连接并将查询结果返回给业务端。GCluster 会接收 SQL、进行解析优化,生成分布式执行计划,选取可操作的节点执行分布式调度,是GBase 8a分布式执行的核心,决定SQL整体执行效率。
节点层(GNode)执行计划
集群拆分的子任务下发至各个数据节点后,单节点生成的单机执行计划,负责本地分片数据的扫描、过滤、局部聚合、局部排序等单机运算,充分利用单节点CPU、IO资源,实现多节点并行执行。
核心执行特性
• 并行执行:优化器自动根据数据分片、节点负载,将查询任务分摊至多个GNode节点并行执行,最大化集群算力;
• 动态优化:支持根据表数据分布、数据量、统计信息,自动选择静态执行(无数据迁移)或动态重分布执行(需跨节点数据迁移);
• SQL重写优化:自动对子查询、关联查询、聚合语句进行等价重写,优化执行链路,例如将exists子查询优化为半连接(semi-join);
执行计划查看方式
GBase 8a 通过 EXPLAIN 命令查看SQL执行计划,支持多种输出模式,适配不同排查场景,仅支持解析SELECT类查询语句,不支持DML、DDL语句。
基础语法
# 标准简洁模式,输出基础执行计划
EXPLAIN SELECT 字段 FROM 表名 WHERE 条件;
# 扩展模式,输出详细字段、执行细节、预估代价
EXPLAIN EXTENDED SELECT 字段 FROM 表名 WHERE 条件;
# 分区模式,展示数据分片、分区扫描信息
EXPLAIN PARTITIONS SELECT 字段 FROM 表名 WHERE 条件;
高级日志排查方式
针对复杂慢SQL,可开启SQL跟踪日志,查看完整分布式执行链路:
#开启全局SQL跟踪
SET GLOBAL gbase_sql_trace=1;
#设置最高详细级别(1-15级,15级最全)
SET GLOBAL gbase_sql_trace_level=3;
开后集群会生成.trc后缀跟踪日志,记录完整分布式执行计划、节点任务执行耗时、数据迁移量等核心信息。
执行计划核心字段详解
GBase 8a EXPLAIN输出核心字段是解读计划、定位瓶颈的关键,各字段含义及风险识别规则如下:
id:计划的步骤,从 00 开始执行,从下往上依次执行的步骤。
MOTION:该步骤的执行结果的处理方式:
RESULT:结果发送到客户端;
GATHER:结果发送到汇总节点;
REDIST(…):结果HASH 重分布,括号中为计算HASH 的列,如果超长则截断为两个点;
NO REDIST:结果直接保存到对应的数据分片,不进行重分布;
BROADCAST:结果拉复制表;
RAND REDIST:结果随机分布到所有节点;
SCALAR N:结果为标量,N 为标量子查询的编号,如果条件中有引用,则使用&xNx&方式引用,例如:
select * from t2 where a > (select max(a) from t1) 或者 select a,(select min(a) from t1) from t2;
OPERATION:
SCAN:单表扫描,并使用条件过滤数据;
Table:单表,没有过滤条件;
SubQueryN:子查询,N 为自动编号;
Step:使用前一个 Step 的结果;
INNER/LEFT/FULL JOIN:连接操作;
WHERE:子查询的WHERE 条件;
GROUP:分组操作;
ORDER:排序操作;
LIMIT:计算 LIMIT,OFFSET;
AGG:(distinct、sum、avg、max、min)聚集操作;
UNION/UNIONALL/MINUS/INTERSECT:并集交集操作
TABLE:
OPERATION 涉及到的表,只显示别名和属性,超长截断为两个点;
HASH 分布表:中括号中显示 HASH 列;
复制表:显示[REP];
随机分布表:显示[DIS];
子查询:OPERATION 列显示 SubQueryN,其中 N 为数字,用来区分不同的子查询;
某个步骤的结果:OPERATION 列显示为 Step,本列显示为其中 N 为用到的步骤的第一列 ID,表示该步骤的结果;
CONDITION:
显示操作的条件,例如 FILTER 的单表条件,JOIN 的连接条件,GROUP BY,ORDER BY,LIMIT 的内容。
如果某个条件可能使用索引,会在有索引的列后进行标注,例如:
WHERE t1.a{S} > 10 表示可能使用 t1.a 的智能(Smart)索引;
WHERE t1.a{H} = 10 表示可能使用 t1.a 的HASH 索引;
WHERE t1.a{H}= t2.b 表示可能使用 t1.a 的HASH 索引;
WHERE t1.a{H} = t2.b{H}表示可能使用 t1.a 和 t2.b 的HASH 索引;
WHERE contains(t1.a{F}…) 表示可能使用 t1.a 的全文(Full Text)索引。
只有物理表的单列包含索引:
物理表单列的>,<,>=,<=,=可能使用智能索引;
物理表单列的=可能使用 HASH 索引,包括等于常量和等值JOIN;
物理表的 contains 函数可能使用全文索引。
核心分布式执行算子解析
GBase 8a针对JOIN、GROUP BY、ORDER BY等核心操作,设计了适配分布式架构的专属执行算子,是执行计划的核心组成,分为静态无迁移、动态重分布两类。
分布式JOIN算子
• 静态Hash Join(最优):关联两张表均为哈希分布表,且关联字段为分片键。各节点本地分片直接关联,无跨节点数据迁移,并行度最高、性能最优,是优先推荐的关联方式。
• 小表广播Join:大表为分片表、小表数据量小。将小表全量广播至所有数据节点,各节点本地完成大小表关联,避免大表数据重分布,适配小维度表关联场景。
• 动态重分布Hash Join:关联字段非分片键,节点本地无法完成关联。优化器自动对其中一张或两张表数据重分片、跨节点迁移数据后再关联,存在数据传输开销,性能次之。
分布式GROUP BY算子
• 静态GROUP BY(最优):GROUP BY字段包含表分片键,各节点本地分片独立完成聚合,仅最终结果汇总至管理节点,无数据迁移,性能极高。
• 动态重分布GROUP BY:GROUP BY字段不包含分片键,本地聚合结果分散,需先将数据按聚合字段重分布,再全局聚合,存在数据迁移开销。
• 两阶段GROUP BY:先各节点局部聚合压缩数据量,再全局汇总聚合,大幅减少跨节点传输数据量,是大数量聚合的核心优化策略。
排序与去重算子
GBase 8a默认优先节点本地排序,再全局归并排序;若执行计划出现Using filesort,代表未利用索引排序,需手动优化索引或改写排序条件。DISTINCT去重逻辑与GROUP BY底层复用相同聚合算子,支持分布式并行去重。
执行计划常见问题与优化原则
高频低效执行特征
1. type字段为ALL:全表全分片扫描,无索引、无有效过滤条件;
2. Extra出现Using temporary:创建临时表存储中间结果,多见于复杂分组、多表关联;
3. Extra出现Using filesort:无法索引排序,触发磁盘文件排序,耗时极高;
4. 大量动态重分布算子:跨节点数据迁移频繁,网络IO成为性能瓶颈;
5. 预估rows与实际结果偏差极大:表统计信息陈旧,优化器生成错误执行计划。
核心优化原则
1. 优先静态执行:建表时合理设计分片键,保证高频JOIN、GROUP BY字段为分片键,规避数据重分布;
2. 及时更新统计信息:大批量数据增删改后,执行ANALYZE TABLE 表名;更新统计信息,保证代价估算准确;
3. 索引精准优化:针对WHERE过滤、JOIN关联、ORDER BY、GROUP BY字段建立适配索引,杜绝全表扫描;
4. 小表优先广播:维度小表优先采用广播关联,避免大表数据迁移;
5. 简化SQL层级:减少多层嵌套子查询,优先使用JOIN替代依赖子查询,降低执行链路复杂度。
简单实战示例
优化前(低效计划)
EXPLAIN
SELECT o.order_id, c.user_name, o.amt
FROM orders o
INNER JOIN customer c
ON o.cust_id = c.cust_id
WHERE o.create_time >= '2025-01-01';
执行计划:
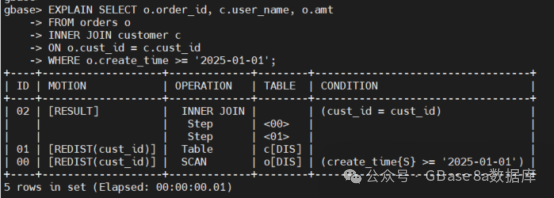
执行特性:两张表为随机分布表,关联时,需要动态数据重分布,效率低效。
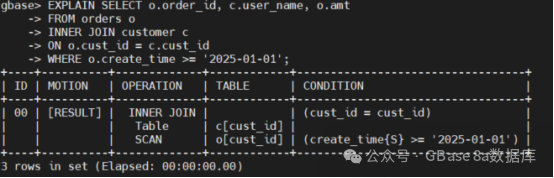
优化后(高效计划)
将orders表和customer的分布键调整为cust_id,实现静态hash join
总结
GBase 8a执行计划的核心本质是分布式并行查询的执行蓝图,区别于单机数据库,其性能瓶颈核心不在于单节点IO,而在于数据重分布、跨节点传输、执行算子选择、统计信息准确性。
日常调优中,需熟练解读EXPLAIN字段,优先识别动态重分布等低效逻辑,通过优化分片键、索引、SQL结构、统计信息,让SQL尽可能走静态无迁移、多节点并行的最优执行计划,充分发挥MPP集群的并行计算能力。