集中式还是分布式?GBase 8c 多模架构,打破二选一困境!
GBase 8c 是南大通用自主研发的新一代AI原生数据库,提供“多态”部署,即单机(最小)、主备式、分布式和存算分离等部署形态。
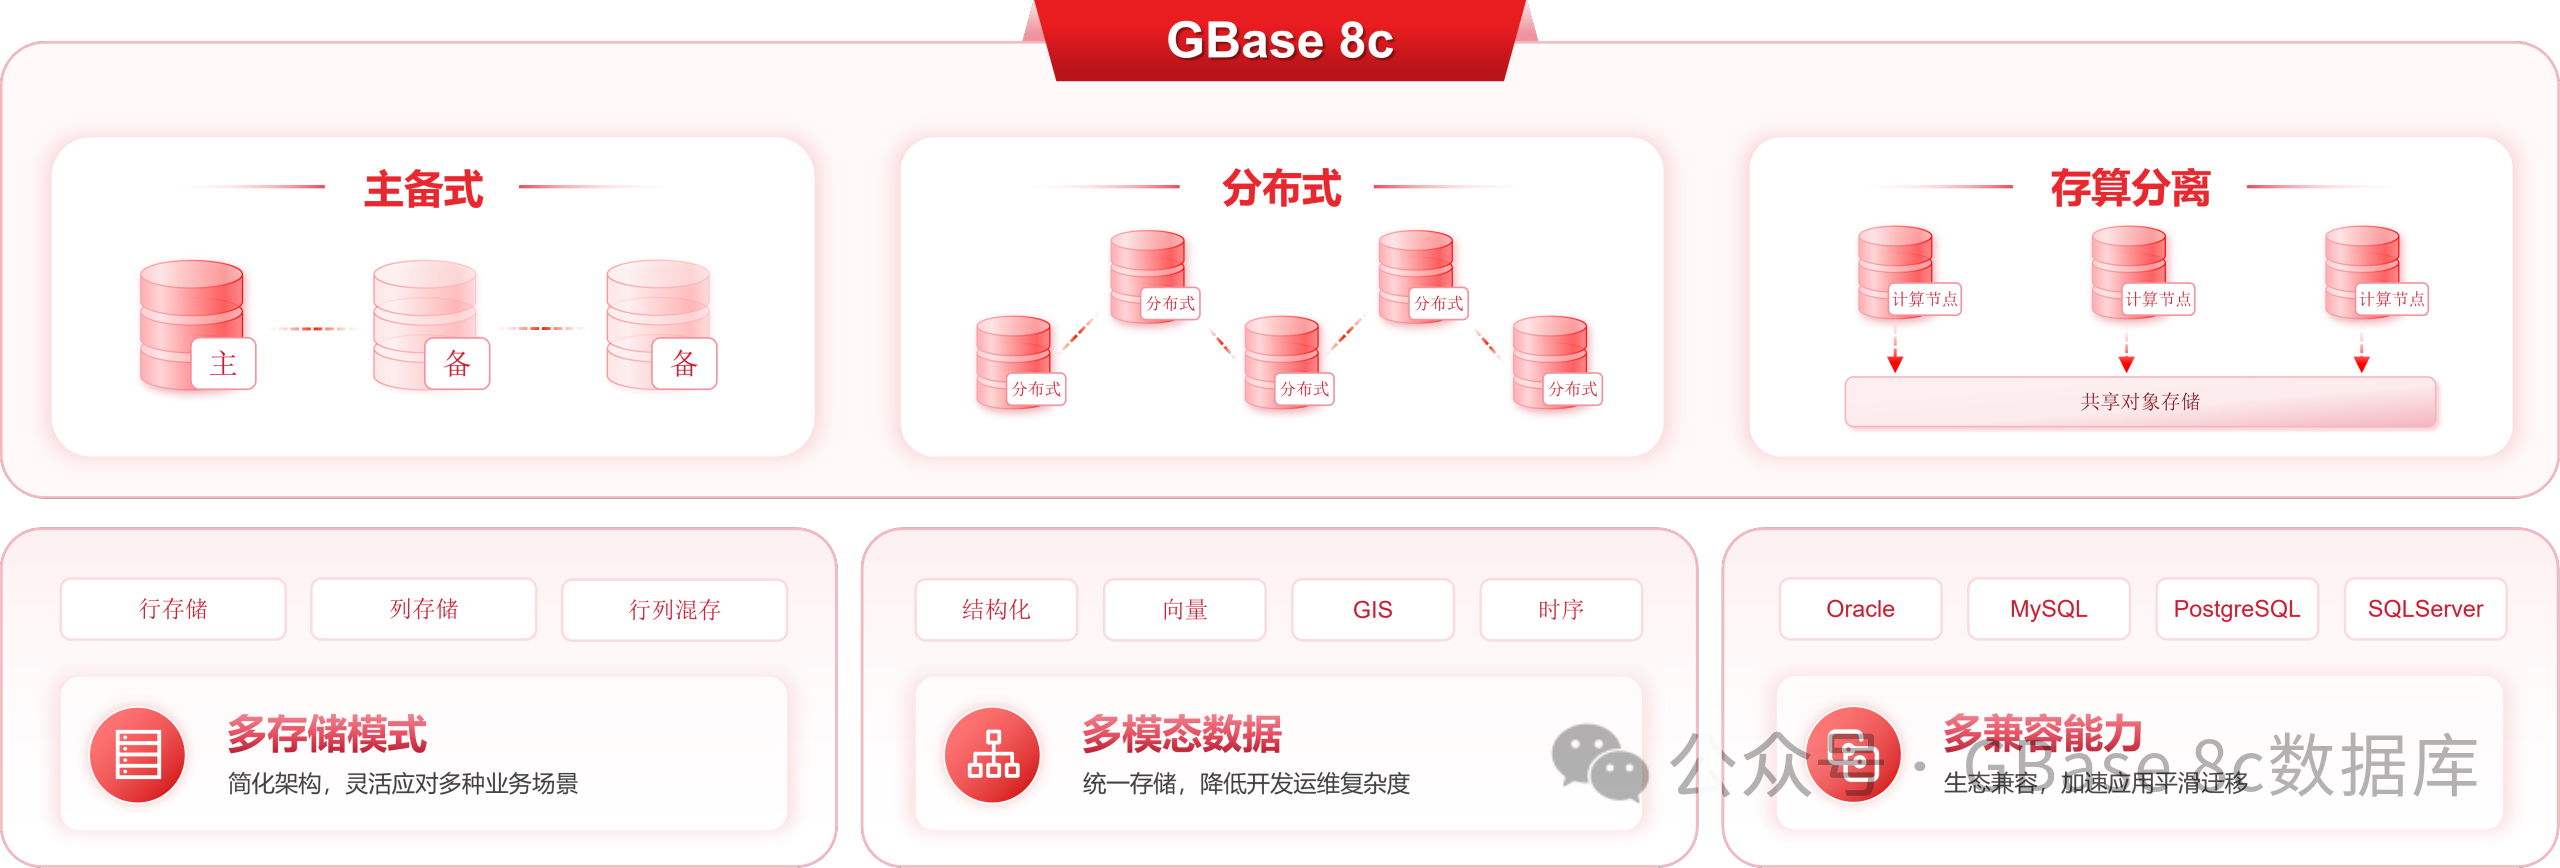
不同部署形态的差异集中在数据如何分布、事务如何协调、资源如何扩展这些方面。因此部署形态的选择,本质上不是"选几套数据库",而是判断业务的数据规模、并发特征、可用性要求、弹性预期与团队运维能力分别落在哪一侧。
架构差异
形态的分野有两条线:一是数据是否分片,二是计算与存储是否解耦。
单机:最小形态,无高可用
单机形态仅一台服务器,无复制、无高可用能力,适合开发测试环境。
生产环境一般从主备形态起步。以下重点介绍生产可用的三种形态。
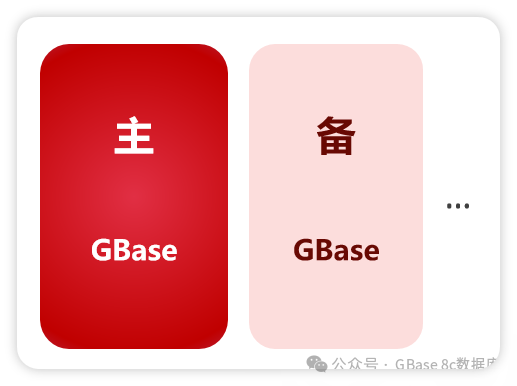
主备式:单一数据集,以复制保障可用性
主备复制架构:主库处理写入,备库通过复制主库数据对外提供只读服务,并在主库不可用时接管其角色。事务日志的同步过程分两步:
主库:写内存、写本地文件、刷盘,随后发送至备库;
备库:接收入内存、写文件、刷盘,回放日志完成数据文件的增量更新。
提供CM管理工具。还可叠加级联备机,用于分担读负载或延伸容灾半径。
存算分离:计算无状态,存储独立成层
存算分离架构将计算与存储解耦:计算节点不再持久保存数据,只负责执行查询;数据统一落在独立的存储层,由存储层负责持久化与页面物化。
各组件职责如下:
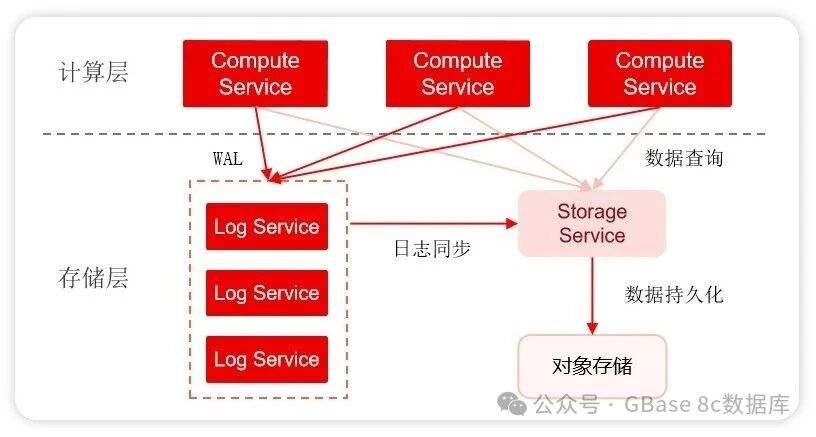
这一架构的直接收益是计算资源的极致弹性:计算节点无状态,资源可在运行中调整而无需重启实例,故障可通过重新拉起或迁移恢复,不必依赖本地数据的复制关系。
分布式:分片存储 + 全局协调
分布式是另一类部署形态,提供数据分片与全局管理集群。
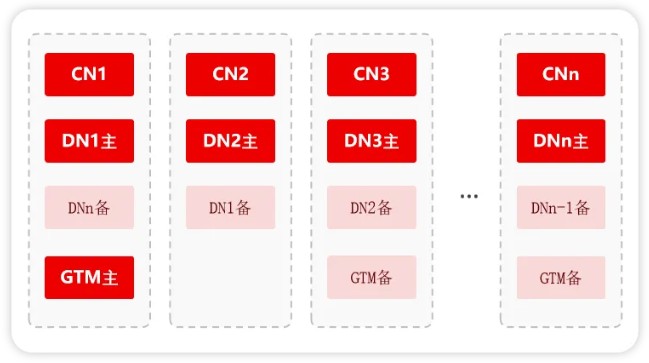
各组件职责如下:
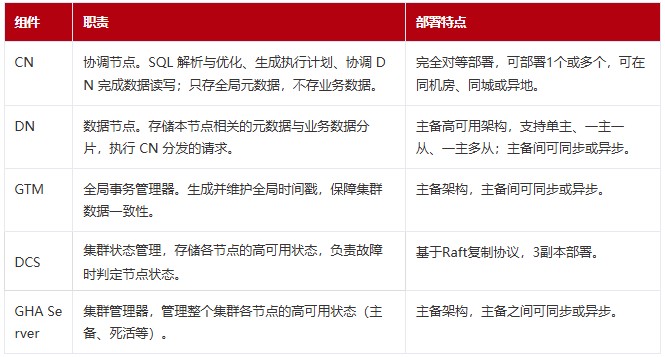
这套设计的目标是全组件级冗余、全局无单点故障。任一节点故障时其他节点可快速接管。支撑两地三中心、异地多活、流容灾等高级别高可用场景。
多维度对比
部署
集中式单机形态只需要一台服务器即可运行,主备式形态最低两台。
存算分离的部署对象是"计算层 + 存储层"两套资源:计算节点无状态,可按需批量拉起与回收,节点数量不与数据量绑定;存储层需要独立规划节点数与副本数,并具备 S3 兼容的对象存储环境。两层规模可分别调整,不必同步扩缩,这也是它弹性能力的部署基础。
分布式部署规划规则比集中式严格得多:
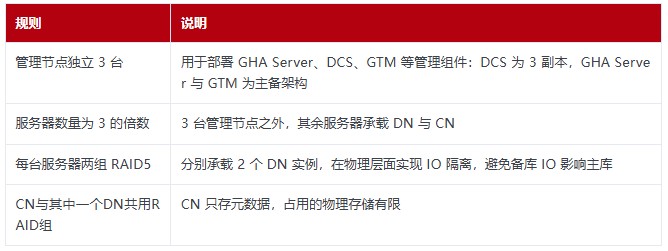
扩展能力
集中式以纵向扩展为主:通过提升单机 CPU、内存、存储配置获得更高的处理能力,主备形态下也可以通过增加备机分担读负载,但整体容量与算力仍受单机上限约束。
存算分离把"扩展"拆成上下两层来做:计算层纵向弹性——资源可在实例运行中调整,无需重启,负载低谷时可将计算资源收缩到接近为零(scale-to-zero),请求到来时再按需唤醒,从而按实际负载而非峰值配置算力;存储层独立扩展——容量增长只与数据量相关,不随计算资源的增减而变化。两层各管一段,扩缩过程互不牵制,这是它与传统主备纵向扩展的主要区别。
分布式支持在线扩缩容:新增数据节点即可提升集群容量与算力,无需中断业务。集群的扩展效率超过 0.9,扩容接近线性收益。这一特性使分布式能够匹配业务规模的持续增长。
分布式的扩展收益并非无条件成立——分片键的选择直接决定扩展效果。若分片键与高频查询条件不匹配,查询会退化为跨节点扫描,节点越多、跨节点协调成本越高,反而抵消了扩容收益。
运维能力
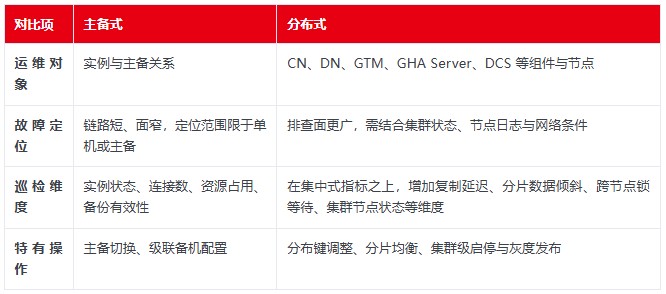
分布式的日常巡检还应关注分片数据倾斜。
存算分离形态的运维对象则多出存储层:除计算实例外,还需关注 WAL 服务与页面服务的节点状态、副本一致性,以及对象存储的可用性与容量。
成本
成本差异主要来自以下方面:
服务器数量
集中式单机 1 台、主备 2 台起步;分布式最小生产规模需要 3 台。
网络条件
分布式的 CN 与 DN、DN 与 DN 之间通信频繁,对节点间网络延迟与带宽更为敏感;集中式的通信主要发生在主备之间。存算分离形态下计算与存储之间的数据交互也依赖网络,且需要一套可用的对象存储环境。
人力投入
分布式的组件数量与巡检维度更多,对运维团队的集群经验要求更高;存算分离多出存储层,对存储与云环境的运维能力有额外要求。
资源计量
存算分离形态下,计算与存储可分别计量:计算按实际占用的资源与时长计费,存储按实际数据量计费,不必按峰值预留算力,因此对负载波动明显的业务更友好。
主备式与分布式形态则以固定规格的服务器为主要成本单元,资源利用率取决于容量规划的准确性。
选项判断依据
综合各方面给出部署选型建议,主要考虑以下方面:
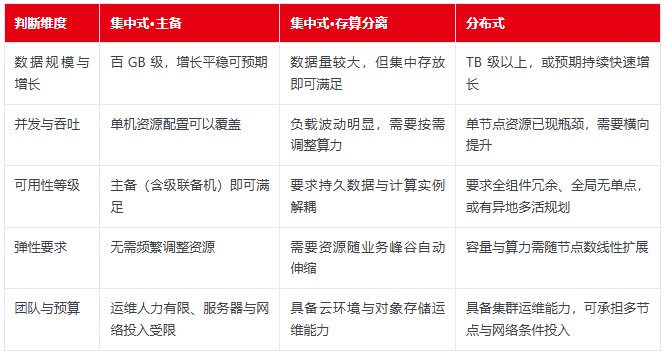
这张表给出的是倾向而非结论。实际项目中常见四类容易被忽略的因素:
分布键的设计成本。分布表与复制表之间无法直接转换,如需变更分布键或改变表类型,须导出 DDL 后重建表;在线修改分布键(ALTER TABLE ... DISTRIBUTE BY HASH(...))虽支持,但会阻塞表访问并消耗较多内存,仅适合数据量较小的场景。因此选择分布式,意味着在表结构设计阶段就要把分布键纳入考虑。
跨节点事务的开销。跨节点事务会增加集群协同成本,可能带来事务延迟。分布式形态下应优先采用本地事务,减少跨节点交互。
业务访问模式。若业务以单表高频点查、小事务为主,集中式的架构开销更低;若涉及大表关联分析、海量数据的并行扫描,分布式的并行处理能力才有发挥空间。
负载波动幅度。负载长期平稳时,存算分离的弹性优势不易体现,固定规格的服务器反而更简单直接;只有当峰谷差距明显、或存在大量间歇性使用的业务环境时,计算资源按需伸缩与收缩至零的价值才真正释放出来。
共同特性
对比之外,更需要强调的是各形态的一致性——这是"多模多态"设计的意义所在。
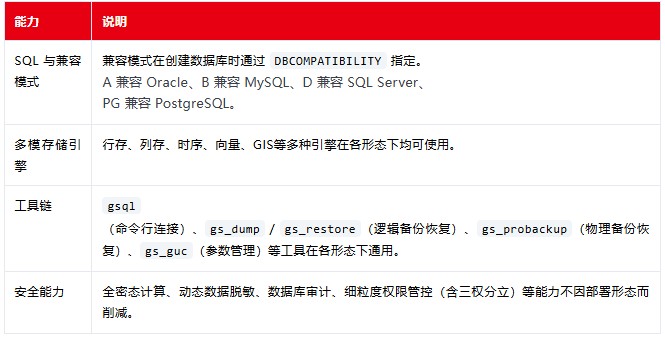
这意味着,即使转换部署形态,应用侧的改造主要围绕分布键选择与跨节点事务治理展开,而不是重写 SQL 或更换技术栈。应用侧语法无需调整,变化主要落在部署方式与资源模型上。
各形态也可以按业务模块分别承载:交易与联机业务部署在主备式,负载波动明显的业务部署在存算分离形态,报表与海量数据场景部署在分布式,三者共用同一套语法、工具与安全策略。
小结
回到最初的问题——集中式还是分布式,取决于业务当前所处的位置。
各形态共享同一内核、同一工具链与同一安全能力,因此选择并非一次性锁定。随着业务量级与负载特征变化,可以在保持应用改动可控的前提下完成形态迁移。选型的落脚点,始终是让架构匹配业务的当前规模、增长预期与成本模型。