告别繁琐数据流转,GBase 8c 让企业架构 “轻” 下来
某业务场景,客户转账要记在交易系统里,风控要盯着海量流水做实时分析,监管报送得从各个系统抽数做报表,现在上智能客服又要单独部署一套大模型检索库。同一份业务数据,分散在好几套系统里来回同步,稍微出点差错就对不上账,半夜出问题运维还要在好几个系统之间挨个排查。GBase 8c的多模一体化,就是要把这些场景收进一个库 —— 数据只存一份,查询各走各路,不用双写,不用同步。
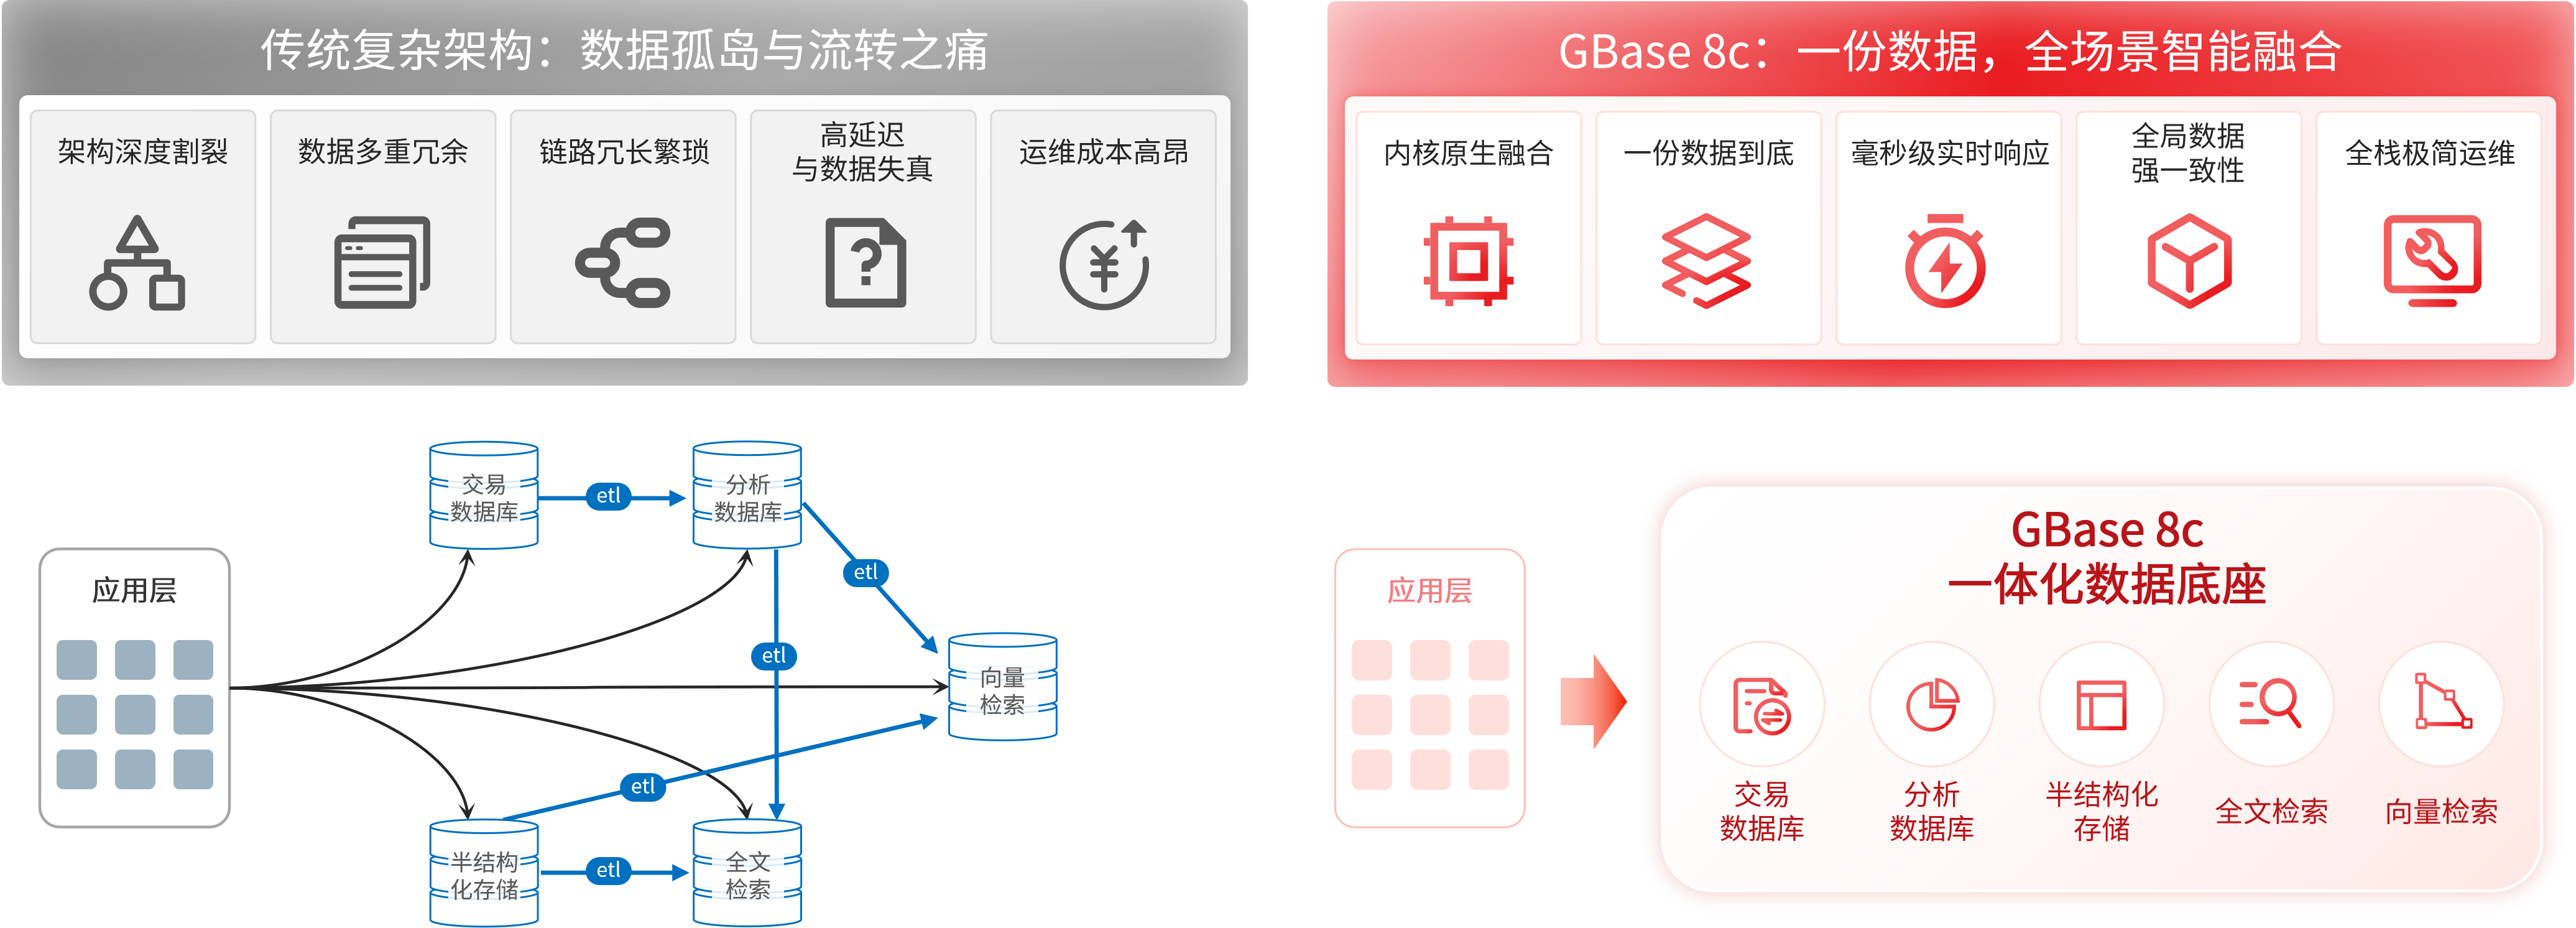
数据类型不断增加,系统架构日趋复杂
在企业信息化过程中,业务初期往往只需一套MySQL即可满足需求。随着数据量增长,需要补充分析库;随后为支持全文检索,部署Elasticsearch;如今大模型应用兴起,又需要部署一套向量数据库。
随之而来的问题是:交易库写入的数据需要同步到分析库,搜索引擎需要从业务库导入数据建立索引,向量库存储embedding又需要重新清洗一遍。系统之间的对接成本,往往高于系统本身的建设成本。
有没有可能,一个数据库就能统一承载这些数据形态?
六种存储模态,统一在一个引擎中
GBase 8c的多模一体化,核心是六种存储模态统一在一个引擎中:
行存,承载交易场景
高并发写入、事务一致性,传统OLTP业务运行于其上。
列存,支撑分析场景
大范围扫描、聚合计算,支撑报表与数仓查询。
行列混存,支撑HTAP场景
同一份数据同时支持交易与分析,无需部署两套库。
向量存储,支撑语义检索
支持最高64000维向量,内置IVFFlat与HNSW索引,大模型推荐、相似性查找可直接在库内完成。
时序存储,支撑监控指标
自动分区、数据压缩与连续聚合,适配设备监控、IoT数据场景。
GIS存储,支撑地理信息
几何类型、GiST索引,位置查询、空间分析无需单独部署GIS系统。
过去这些能力需要六套系统组合而成,如今统一在一个数据库中。
不用双写,不用同步
这才是一体化的真正价值
多模一体化最直接的好处,不是功能多,而是不用再做数据同步。
传统架构中,交易系统写入MySQL后,需通过CDC同步到分析库,再导一份到搜索引擎,再计算embedding存入向量库。中间任何一环出问题,数据就无法对齐。
GBase 8c的思路是:不用双写、不用同步。交易走行存,分析走列存,向量检索走向量索引,全文检索走分词索引——同一份数据,不同查询走不同的物理路径,无需在多个系统之间来回导数据。
以全文检索为例,过去需单独部署Elasticsearch,再搭建数据同步管道导入业务库数据。GBase 8c全文检索,通过中文分词(zhparser)、n元切分(ngram)与三元组模糊匹配(pg_trgm),支持相关性评分与多因子排序,过去ES的检索功能,在GBase 8c中直接通过SQL即可查询。
再以向量检索为例,过去需单独部署向量数据库,将业务数据导出、清洗、计算embedding后写入。GBase 8c向量引擎,支持pgvector兼容接口,业务表直接增加向量类型列,建立HNSW索引,标量过滤与向量检索即可在同一事务中完成。
从实际落地来看,多模一体化最直观的变化,就是系统数量少了,运维链路短了。
三种部署形态,适配不同业务规模
除存储模态外,GBase 8c的"多态"还体现在部署形态上:
主备式架构,适配中小规模业务——两台机器主备切换,部署简单,运维成本低。
分布式架构,适配大规模核心业务——数据分片、弹性扩展,金融核心、政务核心系统可运行于其上。
存算分离架构,适配云原生场景——计算与存储分离扩缩容,业务洪峰时快速扩容,闲时缩容以节省成本。
同一个数据库,从最初的两台机器,到几十台节点,再到云上的弹性集群,无需更换产品,无需迁移数据。
客观而言,多模一体化并非指一个数据库要覆盖所有场景。但对于绝大多数企业来说,交易、分析、检索、向量、时序、GIS 这些日常场景,选择GBase 8c基本就能满足。系统数量少了,数据同步环节少了,团队之间的对接成本自然也就降下来了。
当业务持续增长、数据不断增加、系统持续扩展,或许是时候重新思考:能否减少系统部署数量,减少数据同步环节,减少运维团队投入?GBase 8c的答案是:一个库,即可承载。