3810.36 分!GBase 8c HyBench 登顶技术解密:一份数据如何同时支撑交易与分析
HyBench 3810.36分意味着什么?测试规模拉到1000X,流水表高达60亿行,系统一边扛住9万+的OLTP事务吞吐,一边让分析侧的数据新鲜度(Freshness)保持在0。这组成绩的含金量,不仅在于“快”,更在于“实时”——分析查询读到的不是昨天的快照,而是刚提交的那一行。本文将详细为你拆解,面对交易与分析的物理矛盾,GBase 8c的行列双存机制到底是如何在底层跑通的。
这份高分成绩单,难在哪?
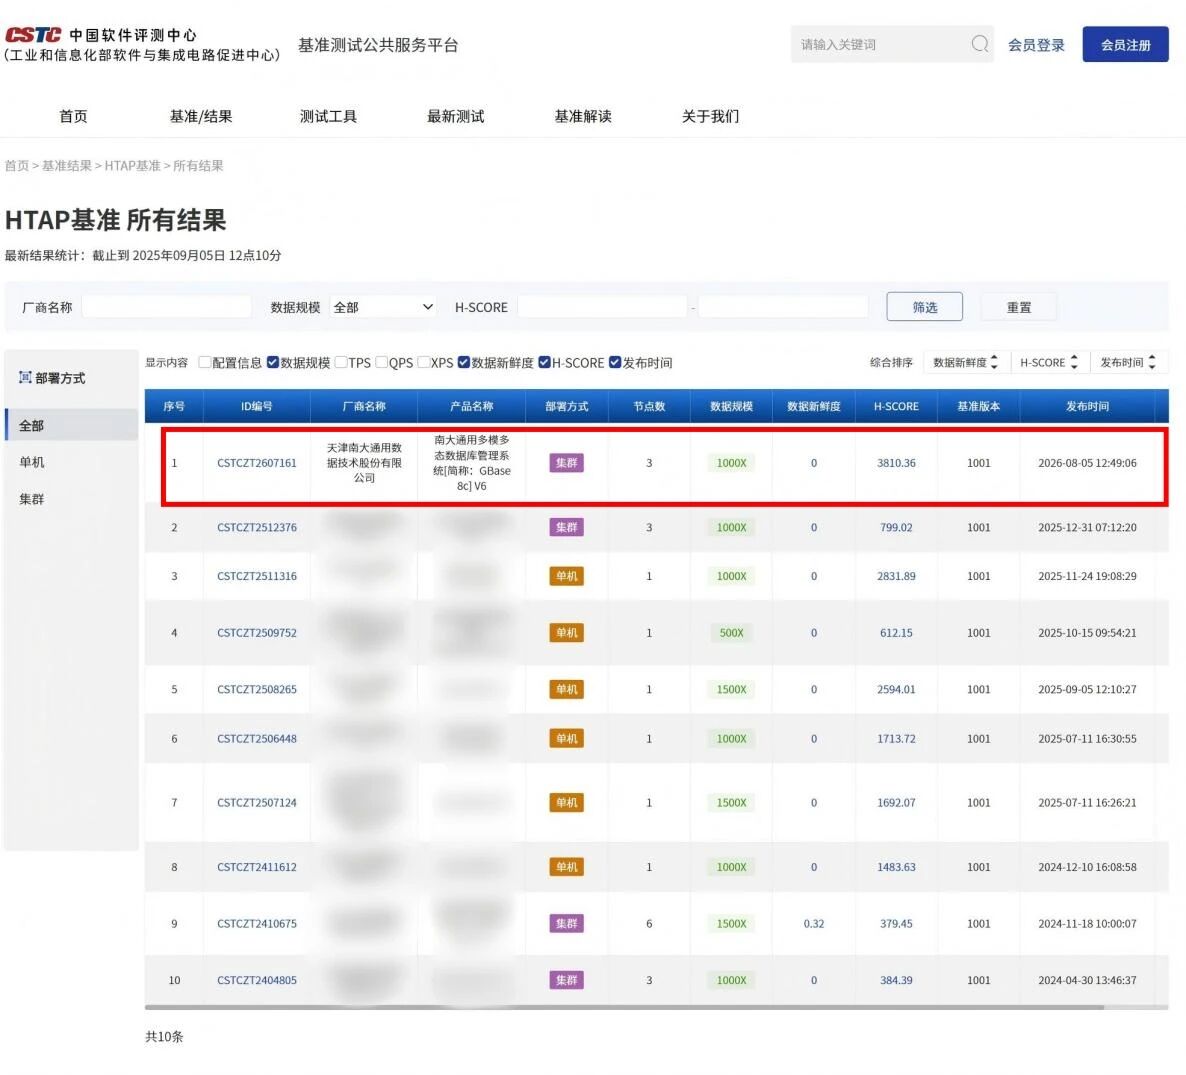
榜单分数只能说明结果。要读懂含金量,得先看看考卷有多难。
中国软件评测中心(CSTC)2026年7月出具的《数据库基准测试报告》(编号ZT022607875)中,HyBench基准测试拉到了1000X的数据规模——仅交易流水表就高达60亿行。
更难的是负载模型。HyBench不是“单项考试”,它将交易和分析两类负载同时压在一套系统上:
一边是极端的并发:9万+的OLTP TPS(纯事务吞吐)。
一边是繁重的计算:跨60亿行的聚合查询。
最关键的一环:数据新鲜度(Freshness)为 0。
“新鲜度”测的是分析查询看到的数据,与事务刚刚提交的数据之间的时间差。0意味着,分析查询完全没有落在“上一批快照”上,它看到的就是刚提交的那一行。
如果这一项不是0,哪怕吞吐再高,本质上还是“实时性打折的HTAP”,和传统双系统加ETL的区别,仅仅在于同步频率。既然要“实时”,就必须在物理存储的根子上动刀。
核心矛盾:行存与列存的“物理排斥”
为什么过去十几年,做HTAP这么难?因为交易和分析对存储的诉求几乎是相反的:
行存(管交易):按行连续存放。一次点查只碰一两个数据页,写入极快。但如果做全表聚合,得把每行的所有列都读进来,绝大部分数据是“白读”的。
列存(管分析):按列压缩存放。聚合时只读参与计算的列,扫描量极小。但单行更新极其痛苦——它需要定位到庞大的列块内部,甚至重写整个压缩块。
传统的解法是物理隔离(两套库+CDC/ETL搬运)。隔离解决了性能矛盾,却带来了数据延迟和链路不一致。
GBase 8c的破局思路,是在同一张表上,同时维护行存和列存两份物理组织(注意,是物理组织,不是两份数据副本)。要让这两套完全相反的物理结构协同工作,底层靠的是一套精密的“工程齿轮”。
机制拆解:一份数据,两套引擎如何运转?
为了让“实时”成立,GBase 8c在底层将数据做了精细的模块化切分。
1. 数据怎么存?从“行块”到“压缩单元(CU)”
在GBase 8c中,行存和列存并不是错乱交织的。系统会将行存表按1024个物理页(约8MB)为单位水平切分,切成一个个“行块(Row Block)”。
随后,系统为每个行块建立一个“行组(Row Group)”,并把这个行块里的数据按列拆解,生成一个个“压缩单元(CU)”。行组有多少列,就生成多少个CU。CU自带事务时间戳等元信息,查询时,系统先看CU的元信息判断要不要读,大幅减少无效I/O。
2. 实时更新怎么扛?Delta表做“缓冲池”
列存的弱点是受不了高频的单行写入。如果每发生一笔交易就去重写列存CU,系统早就卡死了。
GBase 8c的解法是引入一张Delta表(本质是一张行存结构的缓冲表)。新的交易写入时,先落到Delta表里记一笔,攒到一定量后,再由后台异步合并进列存CU。Delta表采用物理页级记录策略——每个物理页只要有了修改,就只记一条,而不是每行记一条。假设每页平均存100行,100万行数据在Delta表里只需要记约1万条记录。这极大压缩了Delta表的体积,对性能影响微乎其微。
3. 查询怎么读?合并读取,自动选路
当业务发起分析查询时,查询优化器会自动判断走行存还是列存。如果走列存,系统不仅会扫描CU,还会把Delta表里的增量一并读进来合并输出。这就是Freshness为0的根本原因:刚提交的写入立刻可见,不存在刷新周期。
深水区:如何解决HTAP系统的“认知偏差”?
机制听上去很完美,但在真实的高并发工程里,还有一个极为隐蔽的坑:CN(协调节点)与DN(数据节点)的信息不一致。
简单来说,执行计划是CN(大脑)生成的,而数据变化是记录在DN(手脚)上的。CN并不感知DN侧Delta表里到底积攒了多少增量。这导致CN经常“盲目乐观”:它单纯基于CU内的静态数据评估代价,以为查询很快,实际上底层数据可能已经高度碎片化。如果任由其发展,列存性能会不断下滑。
为了解决这个“认知偏差”,GBase 8c设定了两道保险:
保险一:阈值触发CU重建。当物理页的变化超过200页,或者行数据增删超过3万行时,系统会强制把任务压入队列,在空闲时从行存重新扫描,构建全新的CU落盘。
保险二:行存兜底。扫描时如果发现CU是旧版本,系统会直接去行存获取完整数据。这正是行列双存的价值:列存重建期间,即使查询临时回退到行存路径、速度有所变慢,也能保证数据不遗漏、结果不出错。
细节:让60亿行不拖后腿的工程决定
除了核心机制,这份成绩单也离不开建表语句里的几个关键决定:
分布键选得准:流水表按转出账户(sourceID)哈希分布,账户表按账户ID分布。按账户维度聚合时,数据本来就在同一个节点上,省去了跨节点重分布的网络开销。
范围分区:流水表按月份做时间戳分区。当查询只需要60天窗口的数据时,分区裁剪直接跳过其他分区,扫描范围从60亿行瞬间收窄。
填充因子(fillfactor=80):对于高频更新的表,每个数据页预留20%空间。这让更新后的新版本尽量留在同一页内,减少页分裂。单条SQL看不出差别,但在48分钟的混合压测里,这能防止表膨胀带来的性能断崖。
3810.36分是这套架构的答卷,而Freshness的“0”才是底层硬实力的内核。HTAP解决的从来不只是峰值性能,更是数据的“实时生命力”。GBase 8c正用这套精密咬合的底层机制,打破交易与分析的物理壁垒,让“既要快,又要准”从愿景变为行业标准。