GBase 8a Hive外部表完整指南
背景
当前很多企业采用 Hive 作为数据湖入口,GBase 8a 作为分析型数据库的组合架构。Hive 负责原始数据存储,GBase 8a 承担高性能分析任务。
但这一架构存在一个根本问题:Hive 与 GBase 8a 是分离的,GBase 8a 无法直接读取 Hive 中的数据,Hive 也无法利用 GBase 8a 的高性能分析能力,形成 数据孤岛。
传统解决方案是 ETL 模式(抽取 → 转换 → 加载),将 Hive 数据手动同步到 GBase 8a。这带来了三个核心痛点:
| 痛点 | 描述 |
|---|---|
| 数据延迟高 | ETL 过程导致数据从 T+1 到分钟级都难以保障 |
| 运维成本高 | 需要人力维护 SQL 抽取、转换、load 语句及数据更新 |
| 实时性不足 | 实时报表、临时联合查询等场景无法满足业务需求 |
核心诉求
企业数据时效性要求已从 T+1 提升至 分钟级,传统 ETL 模式已无法满足业务需求。
对 GBase 8a 的要求:
- 元数据直连 通过使用 Hive Metastore 服务,GBase 8a 直接获取表结构定义,文件存储路径等必要信息,无需手动转换元数据,无需物理迁移数据,保持数据与源系统实时同步。
- 实时性保障 采用数据文件变更监听机制,当 Hive 表数据更新时,GBase 8a 自动感知变化,下次查询即可获取最新数据状态。
- 性能优化策略 支持分区剪枝、谓词下推、哈希索引等优化技术,可仅扫描加载必要数据文件;通过缓存数据,降低访问延迟。
使用方式
GBase 8a 通过 Hive 外部表 解决上述问题,使用仅需两步配置。
第一步:配置连接
GBase 8a Hive 外部表支持两种连接方式:
方式一:Hive Metastore(推荐)
最简单直接的方式,仅需配置一个参数:
-- 配置 Hive Metastore 直连
-- gcluster_connect_to_hive_url = 协议:主机:端口
gcluster_connect_to_hive_url = thrift://192.168.7.112:9083
方式二:HiveServer2
适用于 Metastore 端口不对外开放的场景(如华为 Hive):
-- 配置 HiveServer2 连接
-- gcluster_connect_to_hiveserver2 = 主机?端口?用户?密码?
gcluster_connect_to_hiveserver2 = 192.168.7.112:10000:hive:hive
现场常见情况
部分 Hadoop 发行版(如华为 Hive)的 Metastore 端口不对外开放,此时应选用 HiveServer2 方式迂回获取元数据。
Kerberos 认证
对于带 Kerberos 认证的 Hive 集群,在 HiveServer2 配置基础上添加认证信息:
gcluster_connect_to_hiveserver2 = 主机?端口?用户?密码?超时时间?认证模式?认证机制?认证类型?身份标识?密钥?服务名称?Kerberos服务器名称?版本
Kerberos 参数与 GBase 8a 自身 Kerberos 认证参数一致,直接复用即可。
第二步:创建外部表映射
目前支持 HDFS 与 S3 两种存储系统:
CREATE LOAD READ/WRITE EXTERNAL TABLE table_name (
    column_definition,
    fileid bigint
)
[DISTRIBUTED BY (column_name)]
LOCATION ''
PROPERTIES
    TYPE ''
    DATABASE ''
    TABLE ''
[STORAGE_TYPE = 's3'
S3_REGION ''
S3_ACCESSKEY ''
S3_SECRETKEY ''
S3_ENDPOINT '']
INFORMAT
……
OUTFORMAT
;
关键字段说明:
| 字段 | 说明 |
|---|---|
LOAD |
保留字段,必须写(目前外表全部基于 LOAD 方式实现) |
READ/WRITE |
对应只读外表和可写外表 |
table_name/column_definition |
表名和列名可以自定义,不需要和 Hive 中完全一致 |
fileid bigint |
保留字段,建表时必须定义,标识每一行来自外部哪个文件,用于更新和删除时定位文件 |
LOCATION |
对于 Hive 外部表来说是自动读取的,不需要填写 |
TYPE/DATABASE/TABLE |
填写 Hive 中真实对应的库名和表名,必须一致 |
INFORMAT |
加载参数配置,包括文件类型、列分隔符、空值处理、错误处理等 |
OUTFORMAT |
导出参数,默认与 INFORMAT 一致 |
第三步:查询外部表
创建外部表后,查询与使用 与 GBase 8a 内部表完全一致,无额外学习成本:
外部表不支持 UPDATE / DELETE 操作,因为修改不能影响源数据。
第四步:写入外部表(可写外表)
可写外表仅支持 INSERT INTO ... SELECT 一种写入方式:
-- 非分区表
INSERT INTO table_name SELECT column FROM source_table;

-- 分区表(需额外指定分区信息)
INSERT INTO table_name PARTITION (partition_column = '')
SELECT column FROM source_table;
写入时可通过建表配置选择 追加写 或 覆盖写。
技术架构
Hive 外部表整体分为四个层次:
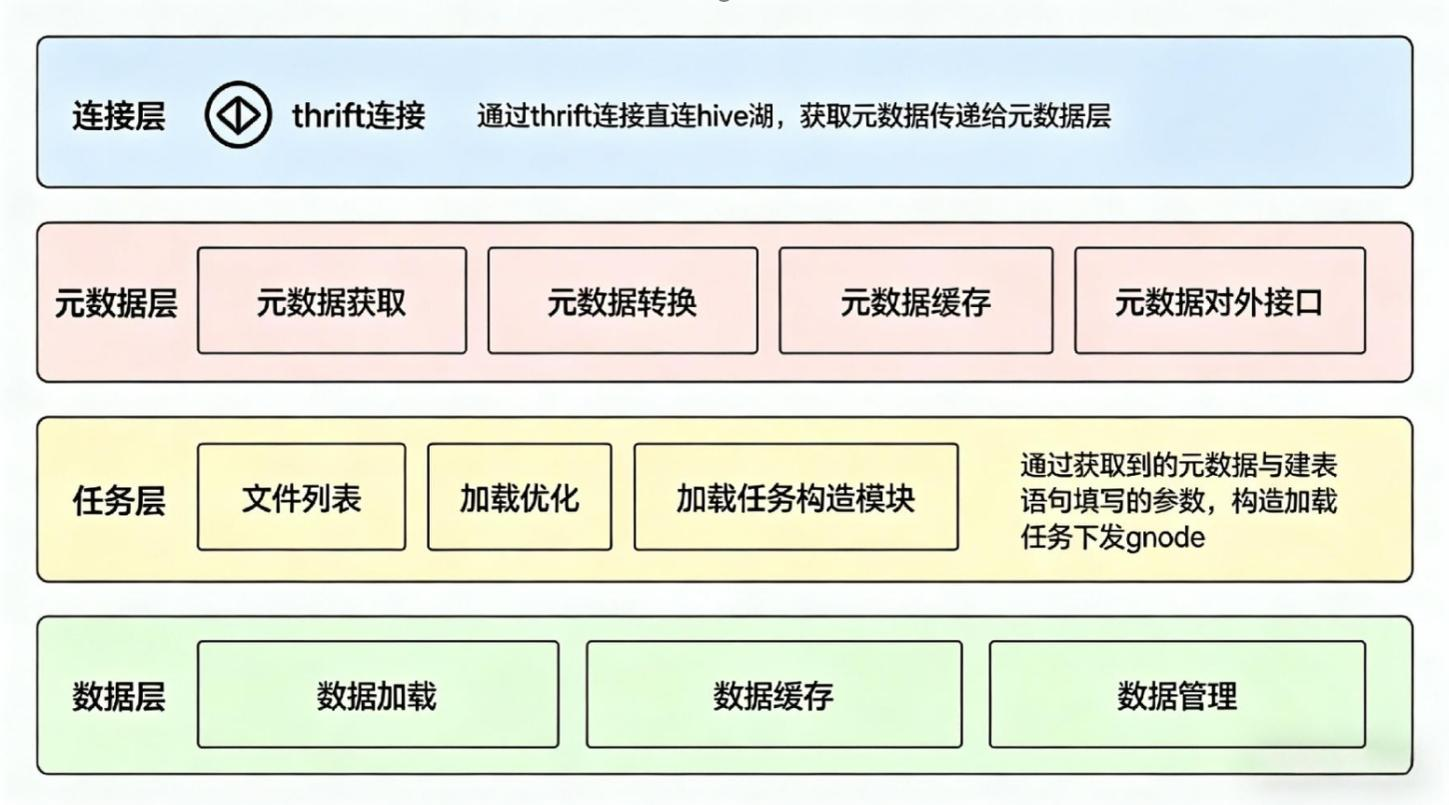
1. 连接层
基于 Thrift 连接池 实现 Hive 连接的统一管理与复用:
- Thrift 协议直连 — 采用 Hive 原生 Thrift 接口直连 Metastore,摒弃中间代理与额外组件,确保链路最短最可靠,支持元数据的实时拉取、查询与完整性校验
- 连接池统一管理 — 实现连接的创建、复用、释放与高可用,避免频繁创建/销毁连接的性能损耗,提升资源利用率
- 高并发与稳定性保障 — 支持多线程安全访问,连接异常时自动重试并剔除无效连接,提供连接数、使用率、占用连接数等核心指标的可视化监控
- 单一职责 — 只负责通道能力建设(建立连接与管理连接池),不参与元数据解析与业务逻辑,实现架构解耦
2. 元数据层
核心功能是元数据的获取 → 转换 → 缓存 → 对外服务:
- 元数据获取 — 拉取 Hive 全量元数据,涵盖库、表、分区、字段类型、存储路径、文件格式等核心内容
- 元数据转换 — 针对 Hive 与 GBase 8a 的数据类型差异进行标准化转换(如 Hive
String→ GBase 8aVARCHAR),不支持的类型在此报错 - 元数据缓存 — 缓存转换后的元数据,下次直接读缓存,提升效率
- 对外接口 — 封装为标准化元数据服务接口,供任务层直接调用
3. 任务层
构造加载任务并下发到 GNode:
- 文件列表管理 — 通过 Hive 端文件的修改时间判断数据是否需要更新,已加载的文件信息缓存至 gcware,避免重复处理,实现增量加载
- 加载优化 — 根据 WHERE 条件对文件列表进行智能过滤,实现分区裁剪和谓词下推,只加载必要数据,大幅减少数据扫描量,提升查询性能
- 任务构造与下发 — 根据外表类型、文件列表、建表限定参数等构造加载任务,下发至 gnode
4. 数据层
完成加载任务并持久化缓存:
- 数据加载 —根据收到的加载任务,进行增量加载
- 数据缓存 — 首次访问后持久化加载到 GBase 8a 本地节点,提升再次访问效率
- 数据写入(可写外表) — 通过导出文件方式完成:
Hive 外表写入流程: 导出数据到临时目录 → 调用 HiveServer2 接口通知 Hive 拉取数据入湖
普通外表写入流程: 根据写入数据量判断追加旧文件或创建新文件到
LOCATION指定目录
核心机制:增量加载
增量加载是 Hive 外部表的核心原理,实现"零 ETL"与"准实时"数据同步:
主要特点:
- 自动感知变更 通过监控文件的修改时间戳,智能判断数据是否发生新增或变更,无需人工标记。
- 查询即时触发 检查过程在用户执行 SELECT 查询时自动触发,无需依赖外部定时调度任务,响应更敏捷。
- 按需增量加载 仅加载新增或变更的文件,避免全量扫描,极大提升查询与加载效率
增量加载执行流程
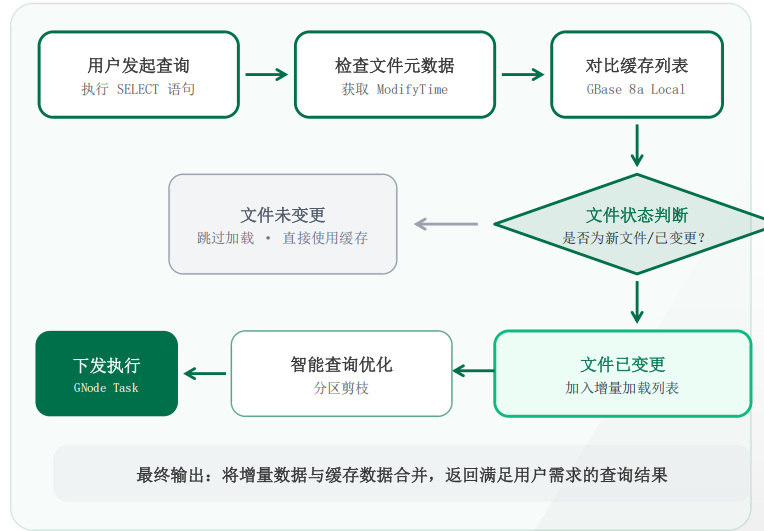
- 用户发起
SELECT查询 - 元数据层拉取连接层可用连接并转换元数据
- 对比缓存文件列表 — 检查文件是否为已加载状态
- 已加载 → 跳过,直接使用缓存
- 未加载/已变更 → 加入增量加载列表
- 任务层对文件列表进行智能查询优化(根据 where 条件进行分区剪枝,获取实际需要的文件)
- 下发到 GNode 执行加载任务
- 最终输出 — 未变更的数据从缓存读取 + 变更的数据增量加载 → 合并返回给用户
- 新加载的文件同时缓存到本地,备下次使用
应用场景
银行离线批量数据统计分析
场景描述:
某商业银行将用户数据按天分区存储在 Hive 数据湖中(一年以上数据),Hive 的分区值不在数据文件中,而是作为目录路径存在,人工加载时无法区分日期。
GBase 8a 端需要:做报表、临时查询、与本地数据关联查询。
传统方式痛点:
- 手动 ETL,T+1 延迟
- 不同日期的数据需要不同表存放
- 分区值不在文件中,需人工保障
使用 Hive 外部表后的效果:
- GBase 8a 建一张 Hive 外部表,自动识别 Hive 分区,通过 WHERE 条件管理 → 一次建表,永久使用
- 无需全量导数据、不用调度、不用写 ETL → 按需查询,用到哪份加载哪份
- 查询时自动同步数据 → 每次查询都是最新数据
传统方式 vs Hive 外部表
| 对比维度 | Hive 外部表 | 传统 ETL |
|---|---|---|
| 数据同步 | 自动增量,查询时自动完成 | 手动搬运,人工查找分区、拼写 LOAD 语句 |
| 查询效率 | 分区裁剪,仅扫描目标分区,分布式计算 | 全量扫描,多为串行处理,效率低 |
| 运维成本 | 低,一次建表永久使用 | 高,每天抽数、建表、维护 |
| 扩展性 | 修改查询语句或元数据配置即可,无需改动数据 | 需重新建表、重新抽取转换,灵活差 |
总结与展望
核心优势
GBase 8a Hive 外部表通过 元数据直连 和 数据本地缓存,实现了:
- 秒级数据新鲜度 — 打破 T+1 限制,满足分钟级实时分析需求
- 零运维调度 — 无需人工维护 ETL 脚本和调度任务
- 高性能查询 — 分区裁剪、谓词下推、哈希索引、数据缓存等多层优化
一句话总结
Hive 外部表 = 零 ETL + 准实时 + 高性能分析通道
参考视频
【G 术时刻第 21 期】GBase 8a Hive 外部表介绍 P1-背景介绍_哔哩哔哩_bilibili
【G 术时刻第 21 期】GBase 8a Hive 外部表介绍 P2-使用方式_哔哩哔哩_bilibili
评论
热门帖子
- 12025-12-01浏览数:183149
- 22023-05-09浏览数:25914
- 42023-09-25浏览数:19556
- 52020-05-11浏览数:18170