GBase 8c 行列双存(HTAP)技术详解
背景
企业数据库负载通常可分为两类:OLTP(联机事务处理) 与 OLAP(联机分析处理)) 。OLTP 以点查、更新为主,追求高并发与低延迟;OLAP 以范围扫描、聚合统计为主,追求吞吐与分析性能。两者的访问模式差异巨大,传统数据库往往只能"二选一":
| 存储模式 | 强项 | 短板 |
|---|---|---|
| 纯行存 | 点查、更新性能优异 | 范围扫描与聚合效率低,如 select count(*) 需全表扫描整张表,性能非常慢 |
| 纯列存 | 列式扫描、聚合分析快 | 无法实时更新,更新性能非常差,基本无法支撑实时写入 |
以 PostgreSQL / openGauss 这类传统行存数据库为例,select count(*) 这类统计查询每次都要顺序扫描整张表,性能瓶颈明显;而列存虽然能彻底缓解这一缺陷,但传统列存又难以做到行级的实时更新。
核心诉求
用户希望用一套数据库同时享有行存的高并发查询与列存的高速分析,实现架构更简单、数据更新更实时,无需在多套系统之间搬运数据。
HTAP(Hybrid Transaction/Analytical Processing,混合事务分析处理) 正是为这一诉求而生。GBase 8c 通过行列双存机制落地 HTAP 能力。
HTAP 行列双存核心思想
行列双存也称之为 HTAP,其核心思想非常直观:
一张表既保存行存数据,又保存列存数据,两份数据独立存储。
- 对于 TP 业务(点查、更新)→ 走行存查询;
- 对于 AP 业务(范围查询、聚合统计,如
select count(1) from k1;)→ 走列存查询。
由此完美适配 OLTP / OLAP 混合负载场景,解决传统单一行存储模式下的性能瓶颈:
- 行存保障高并发点查与实时更新;
- 列存弥补行存全表扫描、聚合统计的性能缺陷;
- 同时克服了传统列存无法实时更新的短板,保证数据更新的实时性;
- 让客户用一套数据库即获得两种能力,架构更简单、数据更新更实时。
架构总览
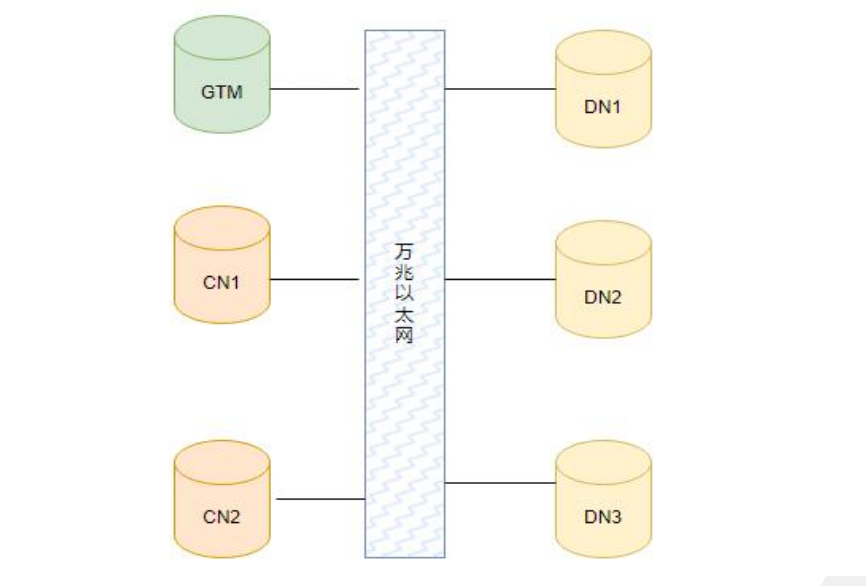
GBase 8c 采用分布式架构,由 GTM 节点 + 多 CN + 多 DN 组成:
| 节点 | 职责 |
|---|---|
| GTM | 全局事务管理器,主要提供事务 ID 等全局事务信息 |
| CN | 对外提供应用接入节点,并参与计算;不保存表数据,仅保存系统表、数据字典等元数据 |
| DN | 存储全部表数据,并承担主要的数据计算 |
表数据全部保存在 DN 节点,CN 节点不持有用户数据,这是理解后续实现的前提。
核心概念
在深入实现之前,先厘清几个关键概念:
行块(Row Block)
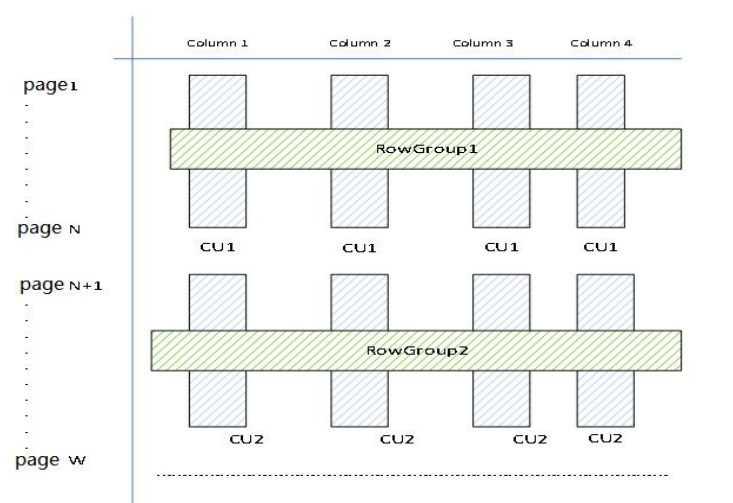
行存数据与列存数据的对应关系,通过对行存数据进行水平切分建立:
- 将行存表按 1024 页为单位进行水平切分,切成一块一块的行块;
- 每个行块是后续列存构建与重建的基本粒度。
Row Group 与 CU
- 列存侧通过 Row Group 对行块进行管理,一个 Row Group 对应一个行块;
- 行块中的每一列数据会形成一个 **CU(Column Unit,列单元)**;
- 一个组有多少列数据,就生成多少个 CU。
Delta 表
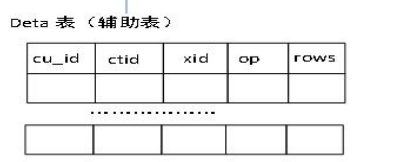
列存数据无法直接承载频繁的增删改,因此引入 Delta 表承接变化数据:
- Delta 表保存对应行存中的行号以及该行数据属于哪个 CU;
- 采用物理页级记录策略——每个物理页只要有修改,就在 Delta 表中保存一条记录,而不是为每一行记录一条;
- 这样 Delta 表的数据量可以减少几个数量级,对列存 insert / update / delete 的性能影响基本可以忽略。
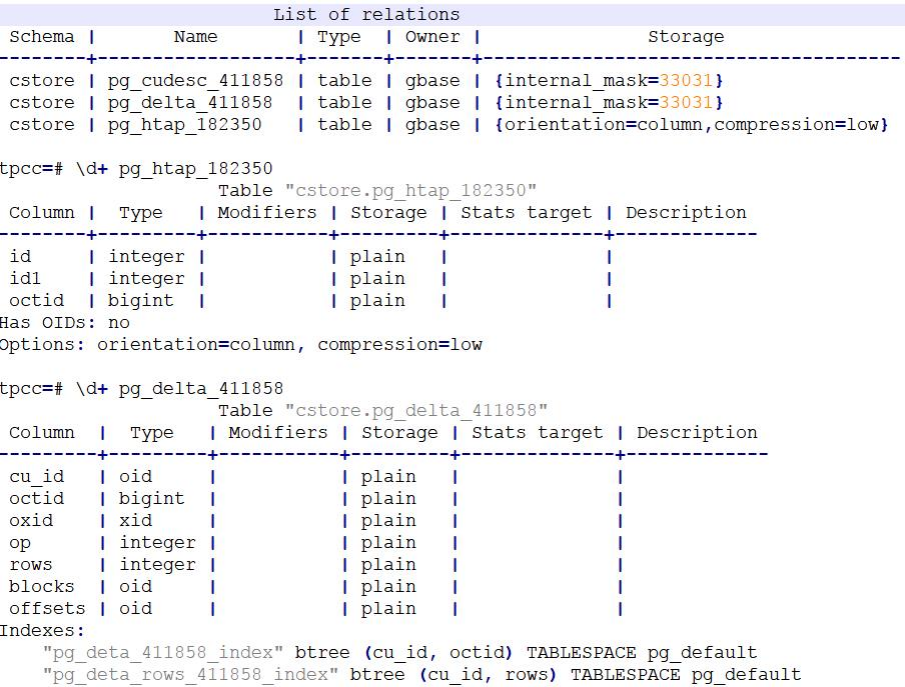
三张物理表
触发行列双存后,每个 DN 会创建三类表协同工作:
| 表 | 作用 |
|---|---|
| 列存表 | 保存列存数据(CU) |
| CU 描述表 | 与列存表共同构成完整列存,通过描述符寻址定位 CU |
| Delta 表 | 保存变化(增量)数据,记录哪些 CU 的哪个物理页发生了变化 |
pg_htap 系统表
- CN 侧维护一个 pg_htap 模块,用于保存行列变换命令;
- 由于 IMCS 描述符等均为内存信息,断电后可能丢失,上电重启时系统会从 pg_htap 表中读取命令,恢复内存中的 cache 信息。
功能实现与效果展示
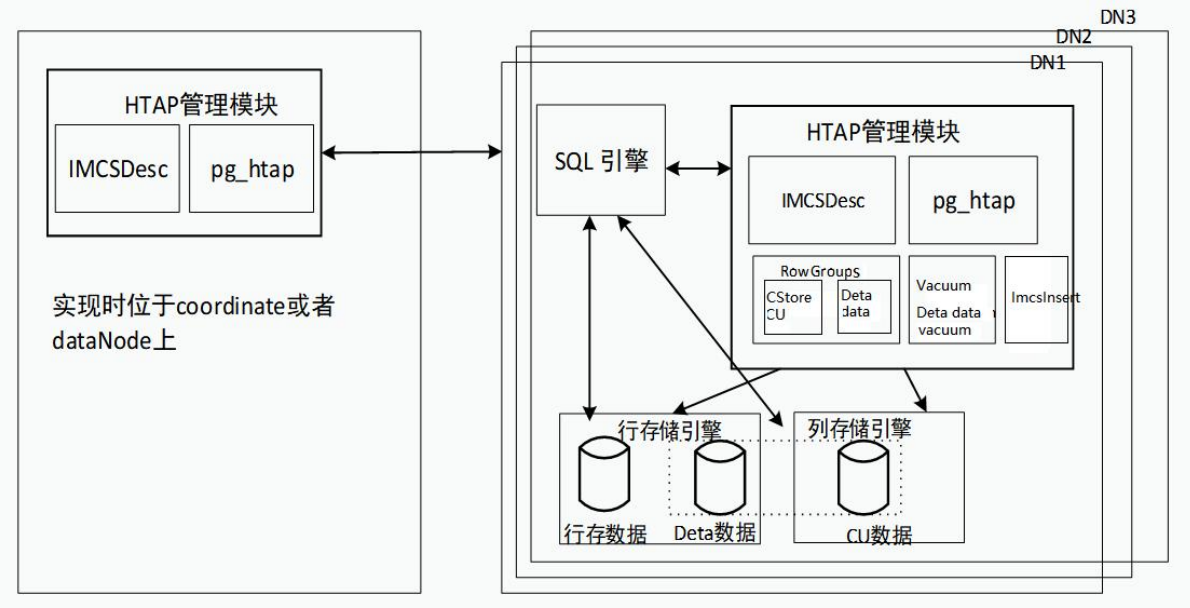
CN 侧:IMCS 描述符
- 在 CN 上实现一个 IMCS 描述符,本质是一个哈希表,记录哪些表已启用行列双存功能;
- 配合 pg_htap 系统表实现命令持久化与上电恢复。
DN 侧:CU 与存储管理
DN 在 CN 功能之外,还多出 CU 与存储的管理:
- CU 组管理:保存 CU 组(即一个行块)的组织关系;
- CU 重建:当增量数据积累过多时对 CU 进行重建;
- CU 更新管理:对 CU 的更新进行管理。
实现上,行列双存表涉及行存存储引擎与列存存储引擎两个存储:
- 行存引擎基本无变化,改动很小;
- 主要改造集中在列存引擎:
- CU 部分保存在列存存储中;
- Delta 表(变化数据)保存在行存中。
触发方式
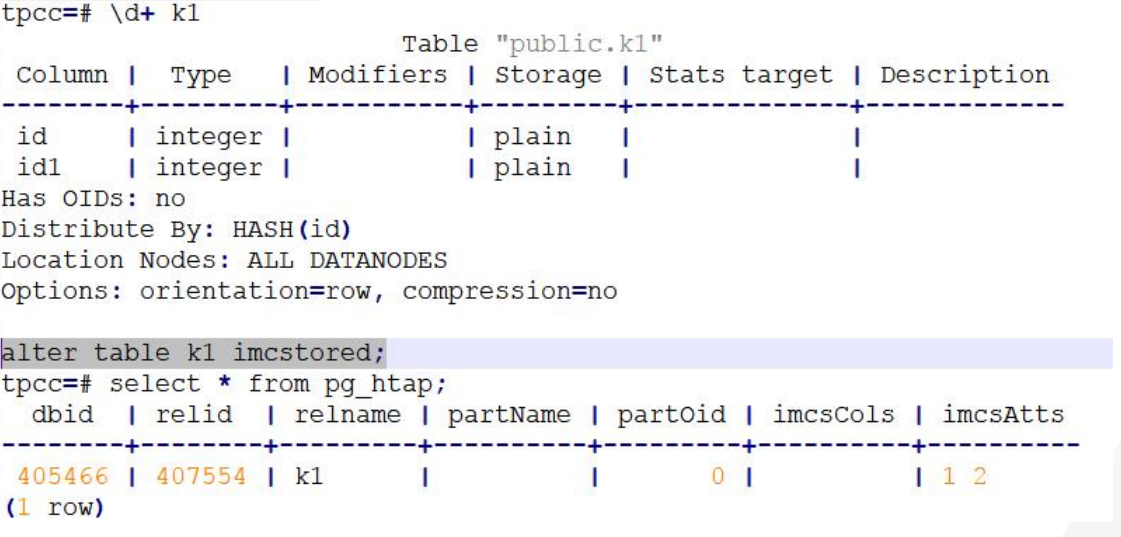
行列双存在建表时不指定,而是在建表完成后,通过命令进行触发:
- 客户端下发行列双存转换命令;
- 命令被保存到系统表(pg_htap 模块);
- 上电重启后依据系统表执行恢复。
查询效果:全表扫描
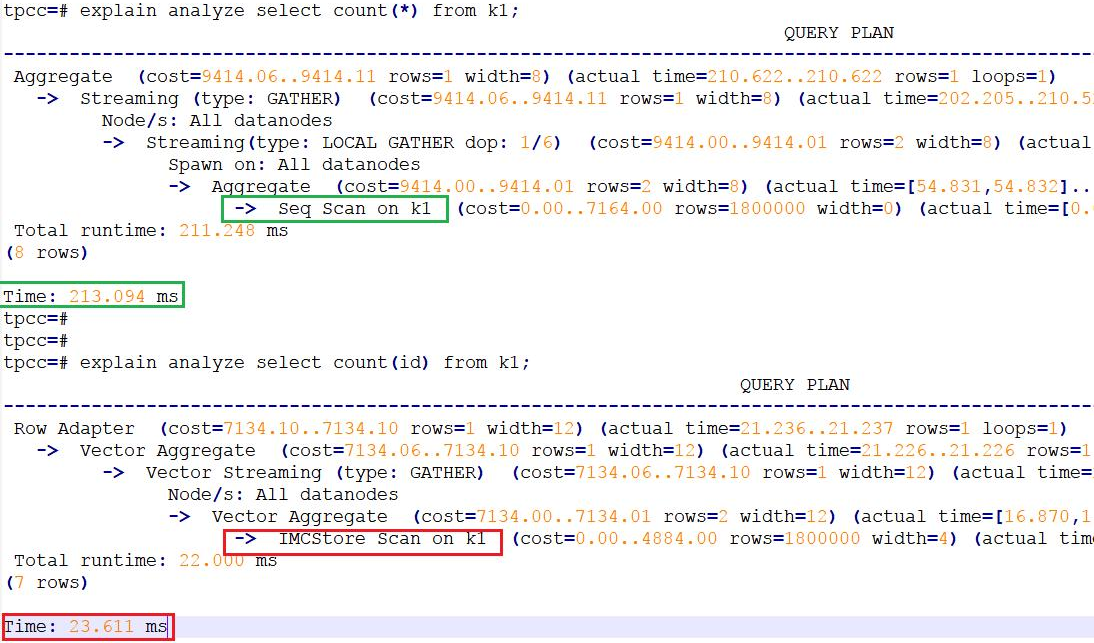
以 select count(*) 为例对比执行路径:
| 场景 | 执行路径 | 效果 |
|---|---|---|
| 传统行存表 | 顺序扫描全表 | 性能慢 |
| 行列双存表 | 走IMCstore 节点(列存数据) | 无增量修改时性能提升数倍 |
实测演示中,同一查询从 213ms 降至 23ms。需要说明的是:如果 Delta 表中存在增量数据,实际仍可取得数倍提升,但效果不会有纯列存演示那么理想。
行列混合查询
支持行列混合查询——一个查询中既包含点查又包含范围查询时:
- 范围查询部分走列存扫描;
- 点查部分走传统索引扫描。
以上路由由数据库系统自动完成,无需人工干预。
关键流程介绍
1. 行列转换流程
行列双存的内部实现流程如下:
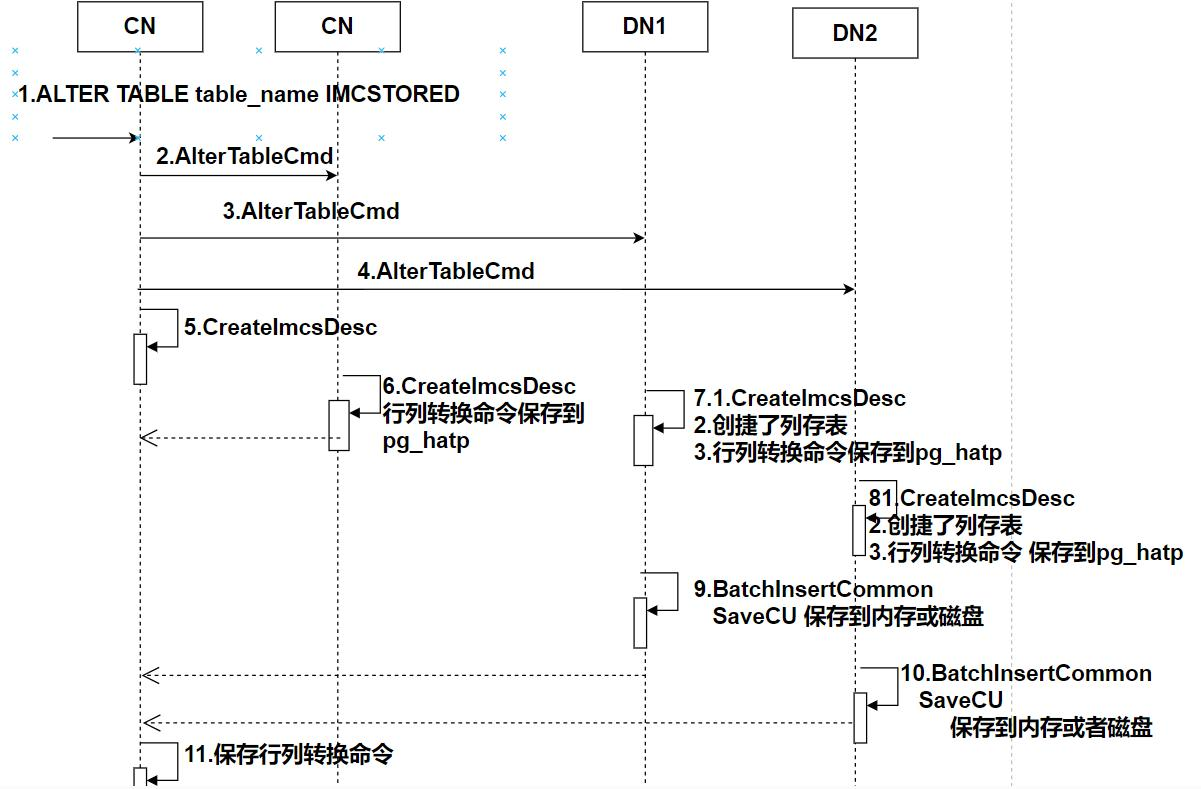
- 客户端通过命令行方式触发转换命令;
- 命令经接入点 CN 向所有 CN 和 DN 广播;
- CN 节点:创建哈希记录,标识该表具有行列双存属性,并将命令保存到系统表(pg_htap 模块);
- DN 节点:除上述动作外,创建列存表、CU 描述表、Delta 表,然后本地多线程遍历行存表——每个线程负责分配到的物理页,扫描数据、构建 CU 并保存到列存中。
当前实现使用 9 个线程进行扫描,尽管保存 CU 环节部分操作仍需串行,整体性能依然可观:几千万行数据大约只需几秒即可完成转换。
2. 查询流程
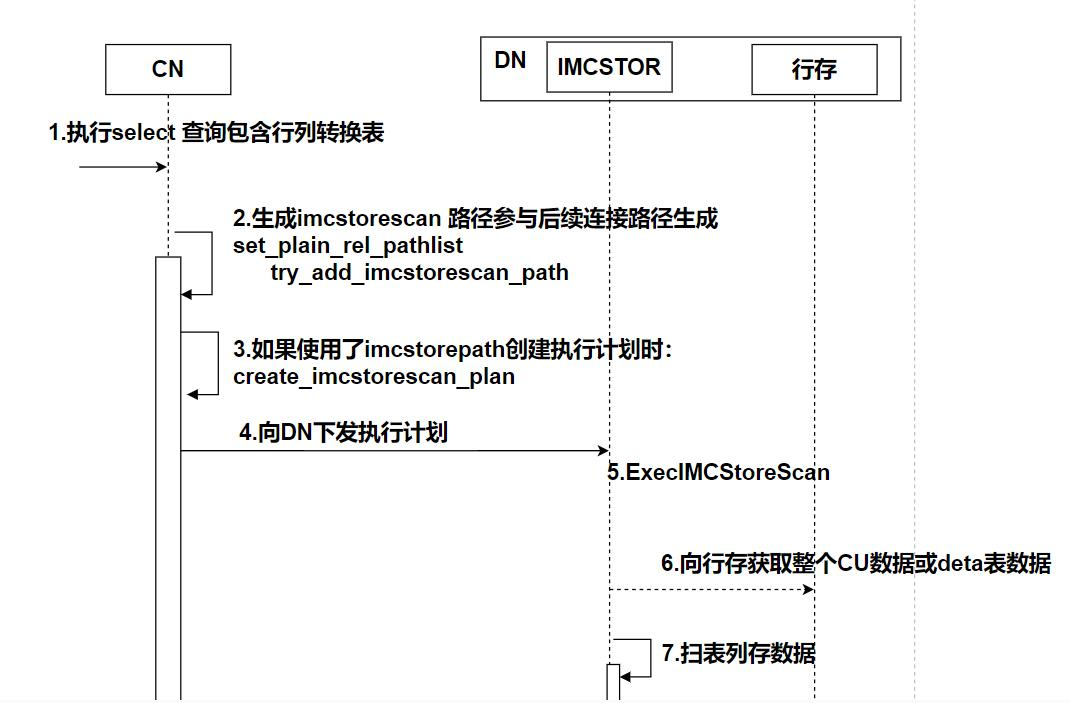
- CN 生成执行计划:检查表是否使能行列双存;
- 若已使能,创建 IMCstore Scan 扫描路径;
- 将该路径与正常顺序扫描路径进行代价比较;
- 若 IMCstore 路径代价更小,则保留该路径,最终生成 IMCstore 执行计划。
- CN 下发执行计划到需要执行的各 DN 节点;
- DN 执行:与传统的"列存作为数据保存容器"不同,这里的 bitmap 等特性均不适用,而是由 IMCstore 模块依据 Delta 表信息重新构建两个扫描位图:
- 增量数据扫描 bitmap;
- 删除 bitmap(CU 的删除位)。
对每个 CU 扫描时,分三种情况处理:
| 情况 | 说明 | 处理方式 |
|---|---|---|
| CU 无效 | CU 损坏;或 CU 重建期间因 MVCC 多版本导致事务不一致——描述符表保存于表内、重建在 DN 独立进行且未在 CN 层锁表,重建完成后可能仍读到旧描述符,旧描述符与新 CU 数据无法对应而报错 | 向行存获取完整 CU 数据 |
| Delta 表有数据 | 先扫描该 CU 的 Delta 表数据,通过删除 bitmap 过滤掉已删除物理页包含的行,再扫描剩余 CU 数据 | Delta 表 + CU 列存联合扫描 |
| 无 CU 记录 | 如新插入的数据尚未生成 CU,仅在 Delta 表有记录 | 向行存获取完整 CU 数据 |
性能退化风险 如果增删改特别多、Delta 表数据量大且 CU 数据基本被删空,查询性能会明显下降。此时需要执行 CU 重建流程:在表空闲时,从行存表重新扫描整份数据,构建完整 CU 后落盘。
3. 数据更新流程
数据更新流程(含增删改及 copy 流程)相对简单:
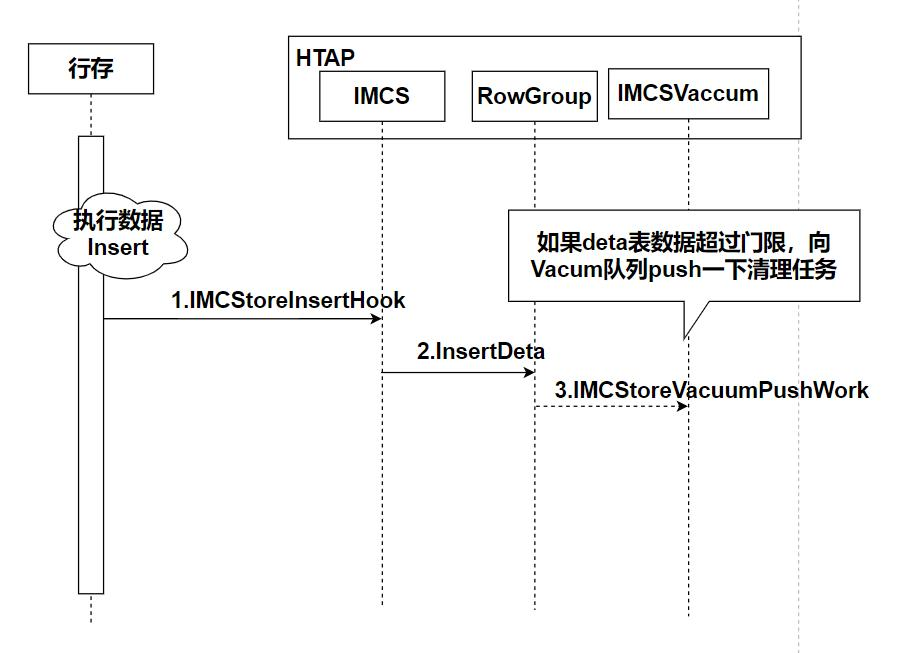
- 行存插入一行数据后,**通知列存(HTAP 模块)**;
- 判断该行对应的物理页是否已有修改记录:
- 无修改 → 在 Delta 表中保存一条记录;
- 已有修改 → 统计信息后直接返回,不再向 Delta 表插入数据。
物理页级记录的效果:假设每个物理页平均保存 100 行数据,插入 100 万行数据,Delta 表只需保存约 1 万条记录。否则 Delta 表数据体量过大会导致重建时频繁修改删除,性能急剧下降,甚至需要完整的 vacuum。
CU 重建任务触发:插入操作完成后,HTAP 模块统计行存表的变化情况(数据量或页数):
- 物理页变化 超过 200 页;
- 或行数据增删变化 超过 3 万行;
满足任一条件即构建一条 CU 重建任务,压入任务队列,由独立的重建线程周期性地取出执行,每次重建一个表的 CU。
4. 自动 CU 重建(HTAP 关键技术)
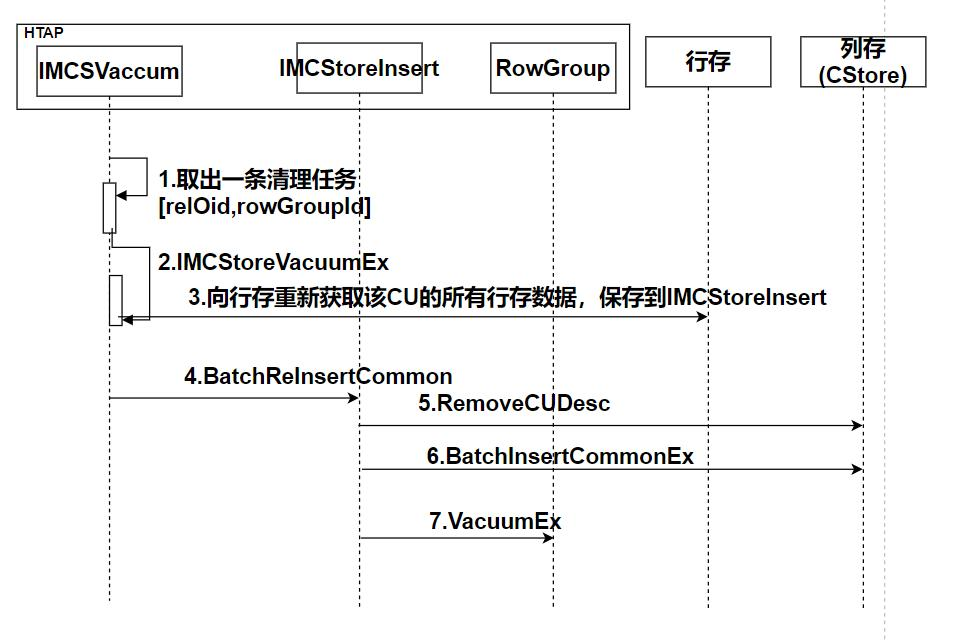
CU 重建是 HTAP 落地的关键核心技术:
如果增量数据非常多而又不能及时重建,对于高并发 TP 业务,可能用不了多久,列存性能就会赶不上行存。
更深层的问题在于 CN 与 DN 信息不一致:执行计划由 CN 生成,而变化数据保存在 DN 侧,CN 并不感知 DN 的增量数据情况。它单纯基于 CU 内数据评估执行计划代价,认为计划很快,实际上数据已高度劣化,按列存查询可能已经非常慢。
重建机制的设计要点:
- 独立任务 + 周期遍历:单独启动任务线程,周期性遍历任务队列,逐表重建;
- Try Open 机制:为避免与表上的排它锁产生死锁,改造原有打开表的方式——不排队、直接重试;若重试多次仍无法打开,则将该表扔回队列尾,继续处理下一条;
- 完整锁表:事务型数据库若不锁表,构建出的 CU 数据可能不完整、不一致,导致列存查询结果与行存差几条数据,因此重建时一定是完整锁表;
- 重建与切换:锁表后扫描该 CU 对应的所有物理页,重新生成 CU → 删除原 CU 描述符 → 将新描述符插入 CU 描述表 → 新 CU 数据落盘。
旧描述符的处理 由于描述符与 CU 数据没有多版本概念,扫描时可能拿到旧描述符对应到新 CU 数据,校验必然不一致。因此扫描时会判断获取到的描述符是否为旧版本:若是,则到行存获取数据,不再扫描 CU。 这也正是"行列双存的优势"——随时可以从行存获取每个 CU 的完整数据,为 CU 重建、故障恢复提供了兜底能力。
总结与展望
核心优势
GBase 8c 行列双存(HTAP)通过"一份数据、两套存储"的设计,实现了:
- 一套数据库搞定混合负载 — TP 点查/更新走行存,AP 范围/聚合查询走列存,自动路由、无需人工干预;
- 架构更简单 — 无需维护两套独立系统及数据搬运链路;
- 更新实时 — 物理页级 Delta 表机制让列存对增删改的开销基本可忽略,克服传统列存无法实时更新的短板;
- 性能有保障 — 全表扫描等 AP 查询性能提升数倍(实测 213ms → 22ms);
- 自愈能力强 — 自动 CU 重建 + 行存兜底,保证长期高并发 TP 写入下列存分析性能不退化的底线。
适用场景
- 同时存在高并发事务写入与实时统计分析的混合负载业务;
- 需要 TP 与 AP 数据强一致、无法容忍 T+1 数据搬运的实时分析场景;
- 希望以一套分布式数据库替代"OLTP 库 + OLAP 库 + ETL"组合架构的客户。
一句话总结
GBase 8c 行列双存(HTAP)= 一份数据两套存储,行存保 TP 高并发,列存提 AP 快分析,自动路由、实时更新、自动重建,一套数据库搞定 OLTP / OLAP 混合负载。
参考视频
【G 术时刻第 22 期】GBase 8c HTAP 介绍 P1-简介_哔哩哔哩_bilibili
评论
热门帖子
- 12025-12-01浏览数:183737
- 22023-05-09浏览数:26443
- 42023-09-25浏览数:20111
- 52020-05-11浏览数:18840