GBase GCDW
架构原理
文章
【转载“GBase 8a数据库”公众号】GBase8a 表空间多路径存储:实现数据存储空间的轻量级扩充
发表于2026-08-27 11:17:34233次浏览0个评论
背景
在数据库中,数据的表空间存储路径信息(tablespace)作为一个属性,一般在数据表创建的时候被指定,且数量只有一个无法变化。例如在 GBASE GCDW 产品中数据文件只能写入固定 S3 桶。当表数据量持续膨胀,单路径会出现 IO 热点、存储容量上限等问题。
为解决单表空间存储路径瓶颈,GBASE GCDW 对 tablespace 进行了多路径改造,重构了 DML/DDL、垃圾回收、备份恢复、LOADER 等核心链路,以 tablespace 多路径替换了原有的单路径,达到了数据文件分散存储在多个 S3 存储桶的目的。
整体存储架构
采用 tablespace 多路径后,整体存储架构如下:
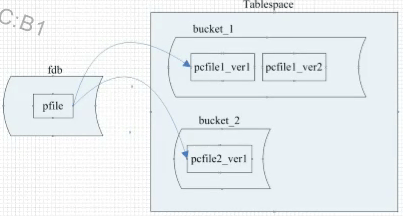
pfile 逻辑对象
- 对应 pcfile1、pcfile2 两个物理文件
- pcfile1 存放在 bucket_1,pcfile2 存放在 bucket_2
pcfile1 发生 update 更新
- 生成新版本 pcfile1_ver2,依旧写入 bucket_1,不会漂移到其他桶
通过这种设计,既实现多桶负载分散,又保证版本数据位置可控
核心改造点:DDL & DML 操作
1. Read 读操作
GBASE 保留了底层 DC 数据的读取接口,其整体流程不需要做过大调整,仅需在调用 DC 数据读取接口前:
- 拿到当前 DC 对应的 tablespace 多路径信息
- 通过 DC 的 pcfile_id,反向关联获取对应的 tablespace 全部路径信息
- 进而实现数据的全量读取
2. Update 更新操作
常规批量 Update 操作:
- 使用 tablespace 多路径信息对象替换原来的单路径信息
- 更新后新版本 DC,必须写入被更新 DC 原来所在的存储桶
- 通过旧 DC 的 pcfile_id 确定目标桶,不能随机挑选路径
- Update 产生的 delta 版本,不能跨桶迁移
- 新版本和旧版本 pcfile 必须落在同一个 S3 bucket,保证版本数据位置可控
Fast Update:
- 操作逻辑为删除旧记录 + 插入新记录
- 删除操作无需变化,插入操作同 Insert 操作
3. Insert 写入(WriteDC)
- 定时更新数据表的 tablespace 多路径信息(总容量、剩余容量等)
- 根据插入时数据表 tablespace 多路径的状态,选择最合适的路径放置到当前 Task 的任务构建中
- 从多条路径中挑选目标存储桶,完成新 DC 数据写入
垃圾回收模块改造
垃圾回收是存储引擎关键模块,多路径改造后:
- 判断逻辑、清理逻辑整体流程不变
- 处理路径需要由之前的单路径变更为多路径
- 后续可实现处理的并发操作,为性能提升留下改造空间
数据迁移、导入导出链路适配
1. 数据迁移
数据迁移在启动操作前:
- 首先获取当前数据表的全部 tablespace 多路径信息
- 并从中获取到最优路径(剩余空间最大等内部策略)
2. 导入导出
导出:
- 遍历数据表所有 tablespace 路径,读取全部数据导出
- 为后续并发提升性能留出优化空间
导入:
- 在导入任务构建中,定时更新数据表的多路径信息
- 在构建导入任务时根据内部策略选择最佳 tablespace 路径
- 构建任务导入数据
表空间多路径功能亮点
| 亮点 | 说明 |
|---|---|
| 对象化路径 | 全链路消灭硬编码字符串路径,统一使用 CTableSpace 对象管理多 S3 路径 |
| 更新不跨桶 | pcfile 更新产生新版本,必须落在原始 pcfile 所在存储桶,仅新 insert 的数据可以选择任意桶 |
| 全链路覆盖 | DML、外表、GC 垃圾回收、数据迁移、LOADER 导入等全部适配 |
| 逻辑复用 | 外表落地 DC、FastUpdate 插入、LOADER 导入,均复用 insert 已有 WriteDC 流程,降低维护成本 |
| 存储路径类型多元化 | 单表可同时支持 S3 多路径及 HDFS 多路径及 S3/HDFS 混合多路径,显著降低表空间扩充的条件要求 |
| 动态扩展 | 数据库表 tablespace 多路径可以动态添加,而不需要重建新的数据库集群,降低用户使用成本 |
评论
登录后才可以发表评论
热门帖子
- 12025-12-01浏览数:183880
- 22023-05-09浏览数:26556
- 42023-09-25浏览数:20247
- 52020-05-11浏览数:19027