GBase 8c
其他
文章
南大通用GBase 8c分布式数据库集群日常巡检指标及巡检工具使用

发表于2026-06-12 13:54:35262次浏览11个评论
本文旨在指导用户使用自动化脚本,完成 GBase 8c 分布式数据库集群的日常基础健康检查,同时对相关检查指标及工具脚本的使用方法进行说明。
1. 准备工作
在执行巡检前,请确保满足以下条件:
- 环境变量:确保当前用户环境已加载数据库环境变量(脚本会自动 source ~/.bashrc)。
- 免密登录:确保当前用户可以通过 SSH 免密登录到集群的任意CN节点。
- 工具依赖:确认系统已安装 gsql 客户端及 gs_ssh 工具。
- 目录权限:脚本所在目录需有写权限,用于生成 results/ 日志目录。
1.1 脚本参数说明
本项目巡检脚本工具使用gbase_monitor_distribute_v4.sh,使用时需要传入如下参数以指定连接信息:
| 参数位置 | 参数名 | 默认值 | 说明 |
|---|---|---|---|
| $1 | database | postgres | 需要连接的数据库名 |
| $2 | port | 5432 | 数据库监听端口 |
| 慢查询阈值 | SLOW_SQL_THRESHOLD | 5 | 需要编辑脚本工具中手动修改 |
1.2 脚本执行示例
# 赋予执行权限
chmod +x gbase_monitor_distribute_v4.sh
# 执行巡检(示例:连接tesdb数据库,端口5432)
./gbase_monitor_distribute_v4.sh tesdb 5432
或
bash gbase_monitor_distribute_v4.sh tesdb 5432
2. 核心指标巡检操作及说明
GBase 8c巡检主要以下12个维度的指标获取进行健康检查,通过脚本实现自动化检查,判定指标是否为正常。
2.1 数据库连接性检查
- 操作:尝试连接指定数据库并执行
SELECT 1。
gsql -d postgres -p 5432 -c “select 1; ”
- 验证:
- 若连接失败,脚本将输出错误信息并终止。
- 成功后,自动获取并显示数据库版本信息(兼容 PanWeiDB/GBase8c 多种格式)。
2.2 CPU 使用率检查
- 操作:通过
gs_ssh在任意CN节点执行top -bn2 -d1获取实时CPU数据。
gs_ssh -c “top -bn2 -d1”
- 指标:
- 用户态 (us)、系统态 (sy)、空闲 (id)、IO等待 (wa)。
- 计算:CPU使用率 = 100 - 空闲率。
- 告警:
- 使用率 > 90% 显示为 红色 (Critical)。
- 使用率 > 70% 显示为 黄色 (Warning)。
2.3 内存使用分析
-
操作系统内存:
gs_ssh -c “free -g”- 通过 gs_ssh free -g 获取节点物理内存。
- 计算公式:(total-available)/total。
- Swap 使用量>0 时发出警告。
-
数据库组件内存:
- 查询 gs_total_memory_detail 视图。
- 计算动态内存使用率 (dynamic_peak_memory/max_dynamic_memory)。
execute direct on all $$
            SELECT
                pgxc_node_str() as node,
                memorytype,
                memorymbytes
            FROM gs_total_memory_detail
            WHERE memorytype IN ('dynamic_peak_memory', 'max_dynamic_memory')
            ORDER BY pgxc_node_str(), memorytype;
2.4 磁盘空间分析
-
节点磁盘
gs_ssh -c “df -h”- 通过 gs_ssh df -h 获取任意CN节点磁盘信息。
- 重点关注:各节点中使用率最高的分区。
-
数据库占用
SELECT pg_size_pretty(pg_database_size(current_database()));- 查询 pg_database_size,列出任意CN用户数据库的大小排序。
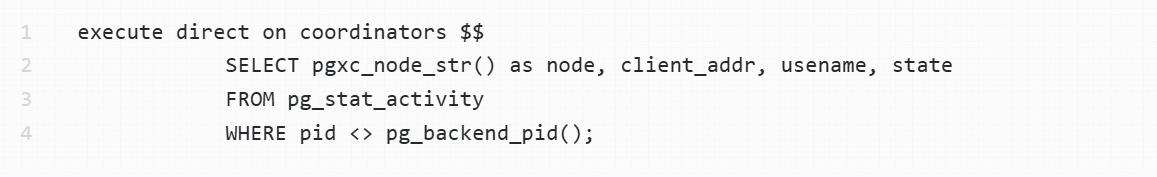
2.5 连接数监控
-
集群计算:
- 获取单 CN 节点的 max_connections。
- 统计 CN 节点数量,计算集群总最大连接数。
-
实时状态:
- 统计当前活跃连接、空闲连接、空闲事务。
- 分布分析:按 CN 节点、按用户、按客户端 IP 进行连接分布统计。
- 异常检测:查找超过 60 秒的长时间空闲事务。
2.6 主从复制延迟检查
execute direct on coordinators $$
SELECT   pgxc_node_str() as node,
                application_name,
                pg_size_pretty(pg_xlog_location_diff(
                    pg_current_xlog_location(),
                    receiver_replay_location
                )) AS replay_lag,
                sync_state
            FROM pg_stat_replication;$$;
- 操作:在 DN 节点上查询 pg_stat_replication。
- 指标:计算 receiver_replay_location 与当前日志位置的差距。
- 单位转换:自动识别并转换延迟单位(Bytes/KB/MB/GB)。
- 判定:
- 延迟 大于 10MB 或包含 GB/TB 级别:严重 (Critical)。
- 延迟 大于 0 且 小于 10MB:警告 (Warning)。
2.7 表膨胀检查
SELECT  schemaname || '.' || relname as table_name,n_live_tup, n_dead_tup,
           CASE WHEN n_live_tup > 0
           THEN round(n_dead_tup::numeric / (n_live_tup + n_dead_tup) * 100, 2)
             ELSE 0
             END as dead_ratio,
             pg_size_pretty(pg_total_relation_size(relid)) as table_size,
             last_vacuum,
             last_autovacuum,
             last_analyze
            FROM pg_stat_user_tables
            WHERE n_dead_tup > 100
            ORDER BY n_dead_tup DESC
            LIMIT 20;
- 范围:遍历任意CN非系统数据库(排除 template0/1)。
- 原理:查询 pg_stat_user_tables,计算死元组比例 (n_dead_tup / (n_live_tup + n_dead_tup))。
- 筛选:死元组数量 > 100 的表。
- 输出:显示膨胀最严重的 TOP 20 表,并提示是否需要 VACUUM。
2.8 全表扫描分析
SELECT   schemaname || '.' || relname as table_name,seq_scan, idx_scan,
            CASE
            WHEN seq_scan + idx_scan > 0
            THEN round(seq_scan::numeric / (seq_scan + idx_scan) * 100, 2)
             ELSE 0
             END as seq_scan_ratio,
             n_live_tup,
             pg_size_pretty(pg_total_relation_size(relid)) as table_size
            FROM pg_stat_user_tables
            WHERE seq_scan > 10
            ORDER BY seq_scan DESC
            LIMIT 10;
- 原理:查询 pg_stat_user_tables,计算全表扫描占比 (seq_scan / (seq_scan + idx_scan))。
- 筛选:全表扫描次数 > 10 的表。
- 优化建议:全表扫描占比 > 50% 或 > 90% 的表标记为警告/严重,建议创建索引。
2.9 未使用索引检查
SELECT  s.schemaname || '.' || s.relname as table_name,
                s.indexrelname as index_name,
                pg_relation_size(s.indexrelid) as index_size_bytes,
                pg_size_pretty(pg_relation_size(s.indexrelid)) as index_size,
                s.idx_scan,
                i.indisunique,
                i.indisprimary
            FROM pg_stat_user_indexes s
            JOIN pg_index i ON s.indexrelid = i.indexrelid
            WHERE s.idx_scan = 0
              AND s.schemaname NOT IN ('pg_catalog', 'information_schema')
              AND NOT i.indisunique
              AND NOT i.indisprimary
            ORDER BY pg_relation_size(s.indexrelid) DESC
            LIMIT 20;
- 范围:遍历任意CN数据库,排除系统 Schema。
- 筛选逻辑:
- idx_scan = 0(从未被使用)。
- 排除唯一约束 (indisunique) 和主键 (indisprimary)。
- 输出:按索引大小排序,列出 TOP 20 未使用索引,供 DBA 评估删除。
2.10 实时慢查询SQL语句获取
execute direct on coordinators $$
SELECT  pgxc_node_str() as node,
                datname,
                pid,
                usename,
                client_addr,
                extract(epoch from (now() - query_start))::int as run_sec,
                wait_event_type,
                regexp_replace(query, E'[\\n\\r]+', ' ', 'g') as query
            FROM pg_stat_activity ;$$;
            WHERE state = 'active'
              AND query_start IS NOT NULL
              AND extract(epoch from (now() - query_start)) > ${SLOW_SQL_THRESHOLD}
              AND pid != pg_backend_pid()
            ORDER BY query_start ASC
            LIMIT 15;$$;
- 慢查询监控
- 默认阈值 5 秒(可配置:${SLOW_SQL_THRESHOLD}替换参数时间即可)。
- 列出当前正在执行且超过阈值的 SQL(Active 状态)。
2.11 锁等待查询及处理
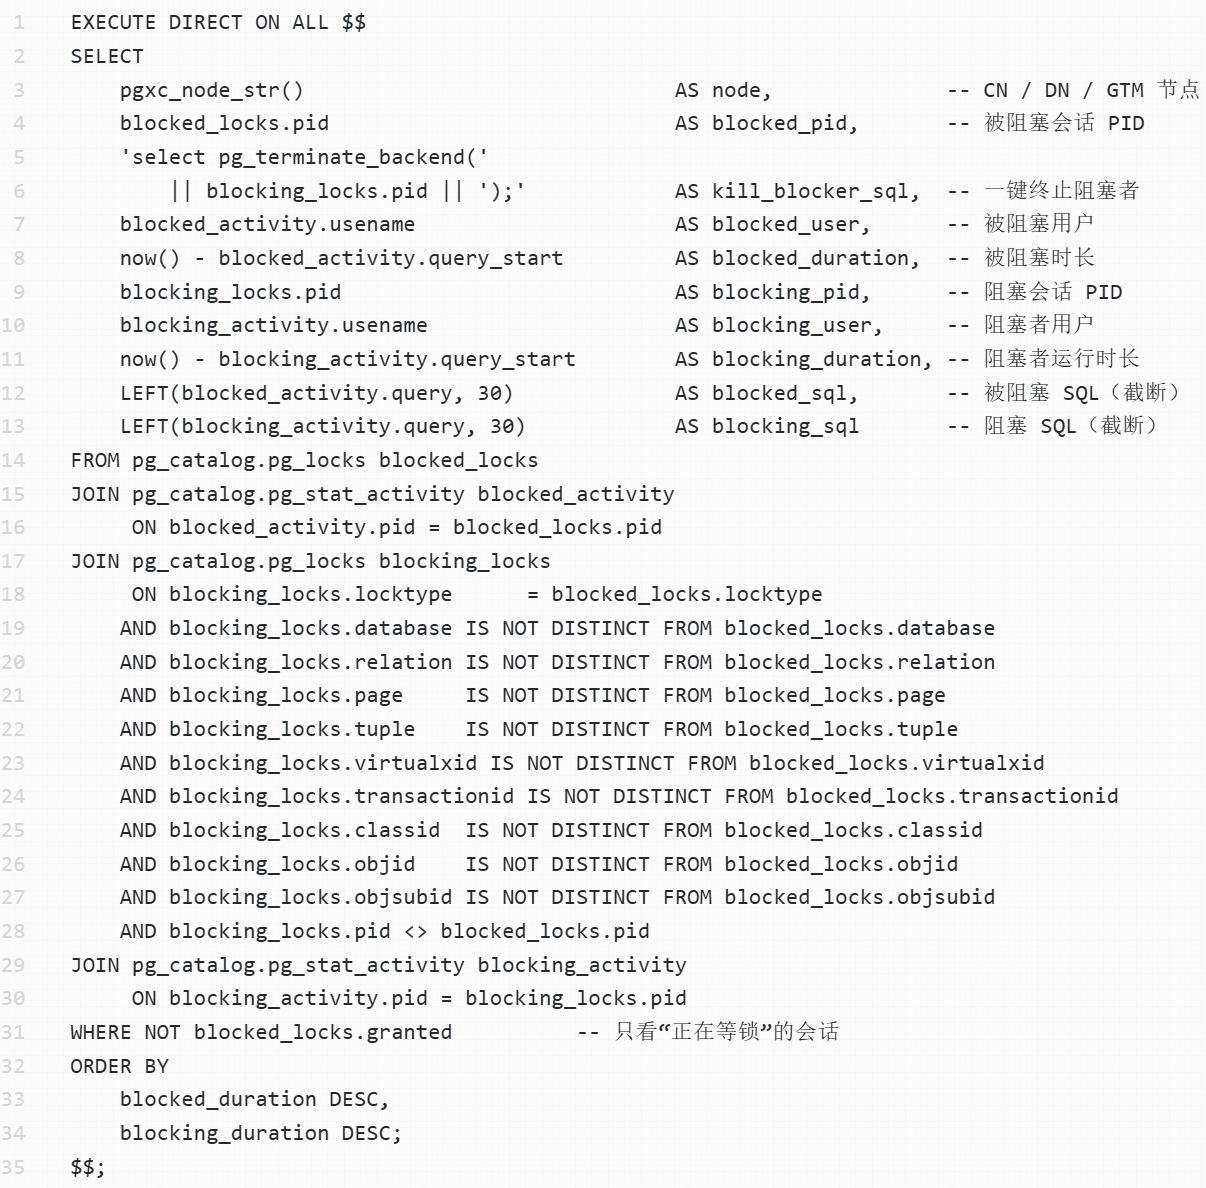
- 锁等待分析
- 查询 pg_stat_activity 关联 pg_blocking_pids。
- 发现锁等待时,输出等待方与阻塞方的 PID、用户及 SQL 语句。
- kill_blocker_sql 定位阻塞会话,在对应节点终止会话以释放锁。
2.12 集群状态查询
- 集群状态查询:
gha_ctl monitor all -l http://10.0.0.1:2389 -HI- 查询集群中所有节点状态均为running,即为正常。
3. 结果汇总与报告
巡检结束后,脚本会生成以下输出示例:
-
屏幕输出:
- 彩色化显示检查结果(绿色 ✓ 正常,黄色 ⚠ 警告,红色 ✗ 严重)。
- 最后显示汇总 Header,包含数据库名、端口、时间及日志路径。
-
日志文件:
- 路径:脚本同级目录下的 results/ 文件夹。
- 主日志:check_dbname_timestamp.log(包含任意CN检查的详细文本)。
- CSV 报告:
- table_bloat_local_*.csv:表膨胀详细数据。
- seq_scan_local_*.csv:全表扫描详细数据。
- unused_indexes_local_*.csv:未使用索引详细数据。
- 慢查询文本:current_slow_sql_local_*.txt。
4. 常见问题与处理建议
| 问题现象 | 可能原因 | 建议操作 |
|---|---|---|
| 连接失败 | 端口未监听、网络不通、实例未启动 | 检查gsql 连接串,确认实例状态 |
| CPU/内存过高 | 慢SQL、统计信息缺失、资源争抢 | 查看"慢查询监控"和"锁等待分析"部分 |
| 复制延迟 | 网络抖动、备机负载高、大事务 | 检查网络带宽,观察备机资源使用率 |
| 表膨胀严重 | autovacuum 未及时执行、长事务阻塞 | 手动执行VACUUM FULL 或调整 autovacuum 参数 |
| 大量全表扫描 | 缺失索引、统计信息过期 | 根据"全表扫描分析"结果创建合适索引 |
评论
登录后才可以发表评论
GBase用户50900发表于 2个月前
总结得很到位,学习。
GBase用户51966发表于 2个月前
内容详实,值得收藏。
一个老汉发表于 2个月前
非常实用的内容,收藏了。
GBase用户51511发表于 2个月前
总结得很到位,学习。
佛洛伊得发表于 2个月前
写得很好,学习了!
塔山发表于 2个月前
总结得很到位,学习。
GBase用户51510发表于 2个月前
非常实用的内容,收藏了。
zwm8168发表于 2个月前
写得真详细。
GBase用户47954发表于 2个月前
感谢作者的精彩分享!

A杰发表于 2个月前
写得真不错,赞一个!
gbase0001发表于 2个月前
总结的很详细,谢谢分享
热门帖子
- 12025-12-01浏览数:183172
- 22023-05-09浏览数:25956
- 42023-09-25浏览数:19602
- 52020-05-11浏览数:18236