GBase 8s执行计划解析与性能调优实践
执行计划介绍
在开发过程中,经常会遇到SQL查询慢,系统反应时间长的情况,这时候就需要执行计划来帮助分析问题。
常见的慢SQL主要是由4个原因造成的:
- SQL查询逻辑复杂 复杂的多表关联、子查询嵌套以及不合理的连接条件,会导致优化器生成低效执行计划,增加查询耗时。例如相关子查询若未转化为表连接,可能导致重复扫描,影响性能。
- 索引设计与使用不当 缺乏有效索引导致全表扫描,或索引过度冗余增加写入开销。例如,为低基数列创建索引可能无法发挥作用,而未创建覆盖索引则会增加回表查询成本。
- 统计信息不准确或缺失 优化器依赖统计信息生成计划,若统计信息过时或缺失,可能导致错误估算行数和选择低效访问路径,如错误选择全表扫描而非索引扫描。
- 系统资源与参数配置瓶颈 CPU、内存、I/O资源分配不合理,或数据库参数(如work_mem、连接池大小)设置不当,会限制数据库性能潜力。例如,内存不足可能导致频繁磁盘交换,降低查询速度。
执行计划核心价值: 执行计划是数据库优化器将SQL语句转化为具体物理操作步骤的方案,揭示查询执行路径、资源消耗和数据处理逻辑,是定位性能瓶颈、优化SQL效率的关键工具。
GBase 8s执行计划的关键作用: 在GBase 8s数据库中,执行计划帮助开发者理解表访问顺序、索引使用情况、连接方式等核心执行细节,为评估和改进查询性能提供可视化依据。通过解读执行计划中的预估开销、返回行数、扫描方式等信息,可针对性调整索引策略、SQL结构或数据库参数,显著改善查询响应时间,构建高效数据处理体系。
执行计划生成与配置
SET EXPLAIN命令是GBase 8s数据库中用于生成和查看SQL语句执行计划的关键工具,通过它可以获取优化器对SQL语句的执行评估,帮助开发者理解查询执行过程,进而优化查询性能。
主要选项及功能说明:
| 选项 | 功能说明 |
|---|---|
| ON | 为后续每个查询生成评估并写入当前目录输出文件,若文件存在则追加内容 |
| AVOID_EXECUTE | 生成查询计划但防止SELECT、INSERT、UPDATE、DELETE语句实际执行 |
| FILE TO | 生成评估并指定输出文件位置(数据库服务端文件路径),不指定的话默认输出在/home/gbasedbt/sqexplain.out |
| OFF | 终止SET EXPLAIN,不再生成和写入评估 |
常用使用场景示例:
- 如需仅了解SQL查询计划而不执行语句,可使用
SET EXPLAIN ON AVOID_EXECUTE; - 若要将查询计划输出到指定文件,可执行
SET EXPLAIN FILE TO '/home/gbasedbt/aaa.out';之后再执行目标SQL语句。
执行计划核心组成要素
OPTIMIZATION TIMESTAMP
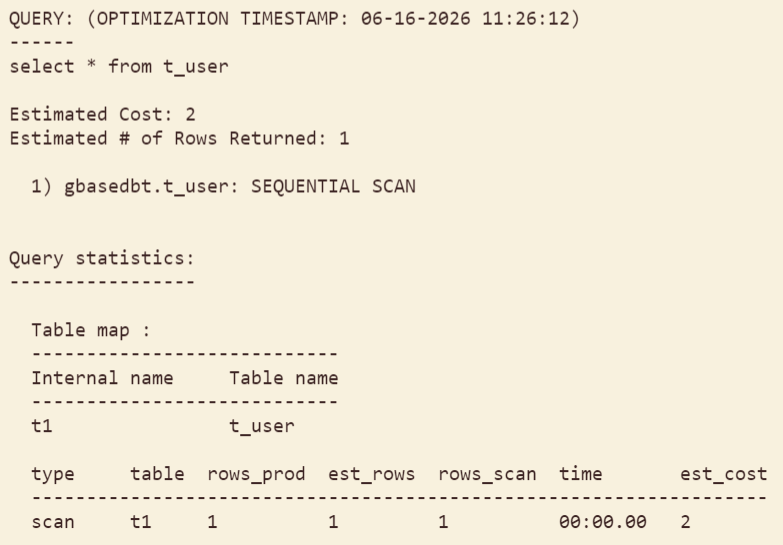
执行时间(OPTIMIZATION TIMESTAMP)指的是数据库优化器生成查询计划的实际时间,它记录了SQL语句优化过程的起始时刻。执行时间有助于追踪查询计划的生成时间点,便于在性能分析和问题排查时,结合系统当时的负载情况进行综合判断。
执行计划中会完整展示原SQL语句,这是分析执行计划的基础,确保开发人员所分析的计划与待优化的SQL语句完全一致。通过将执行时间与查询语句关联,可帮助定位特定时间点下SQL语句的执行计划情况,为后续的性能优化提供时间维度的参考。
Estimated Cost
预估开销值(Estimated Cost)是GBase 8s数据库优化器用来决定查询路径的数值,它是优化器基于统计信息和内部算法计算出的抽象代价指标。预估开销值通常包括CPU成本、I/O成本等,其绝对值大小无实际意义,重点在于不同执行计划间开销值的相对差异,辅助优化器选择代价更低的执行路径。
预估开销值与查询实际耗时不直接相关,不能用于比较不同SQL语句的执行效率,但可用于比较相同SQL在不同执行计划下的执行开销。
Estimated # of Rows Returned
预估返回行数是查询计划中优化器根据统计信息估算的SQL语句执行后返回的数据行数,是优化器选择执行路径的重要参考依据。该数值直接影响优化器对表连接方式(如Hash Join、Nested Loop)、索引使用策略的选择,准确的预估能帮助生成更优执行计划,提升查询效率。
若统计信息过时或缺失,可能导致预估行数与实际返回行数偏差较大(如实际1000行但预估10行),优化器可能误选低效执行路径。需定期执行UPDATE STATISTICS更新统计信息,确保预估准确性。
表的访问顺序与访问方法
- 表访问顺序的优化逻辑 数据库优化器根据表的大小、数据分布及关联条件决定访问顺序,通常小表优先访问以减少后续关联的数据量。例如,在多表JOIN时,优化器可能选择将记录数少的表作为驱动表,以降低嵌套循环的外层迭代次数。
- 常见表访问方法解析 GBase 8s支持多种访问方法:顺序扫描(Seq Scan)适用于无索引或小表查询;索引扫描(Index Scan)通过索引定位数据后回表读取;键值扫描(Key-only index scan)直接从索引获取所需数据,无需回表,效率更高。
- 访问方法对性能的影响 全表扫描在数据量大时性能较差,而合理的索引扫描可显著提升效率。例如,对订单表按客户ID创建索引后,查询特定客户订单可从全表扫描转为索引扫描,响应时间从秒级降至毫秒级。
索引路径与实际执行情况统计
- 索引路径的识别与分析 执行计划中会明确显示查询所使用的索引名称及类型,如B-Tree索引、复合索引等。通过分析索引路径,可判断优化器是否选择了预期的高效索引,例如在等值查询中是否使用了主键索引,或在范围查询中是否利用了合适的复合索引。
- 实际执行情况统计的关键 通过对比执行计划中的预估返回行数(Estimated # of Rows Returned)与实际返回行数,可判断统计信息的准确性。若偏差较大(如预估100行实际返回1000行),可能需要更新统计信息或调整索引策略以优化查询计划。
- 常见索引扫描方式解析 GBase 8s支持多种索引扫描方式,包括索引扫描(Index scan)、键值扫描(Key-only index scan)、键优先扫描(Key-first index scan)等。例如,当查询列全部包含在索引中时,会执行键值扫描以避免回表操作,显著提升效率。
GBase 8s优化器原理RBO与CBO
基于规则的优化RBO
基于规则的优化(RBO)通过一系列预先定义的规则对逻辑计划进行等价转换,以提高查询效率。这种方法减少了参与计算的数据量,降低了重复计算的代价。
RBO相对于CBO而言更为成熟,常用的规则基于经验制定,覆盖了大部分查询场景,并且易于扩展。但RBO不够灵活,因为在这一阶段,系统对物理特征(如表的底层存储形式和实际数据量)尚未感知。
常见RBO优化手段主要包括谓词下推(Predicate Pushdown)、常量折叠(Constant Folding)和列裁剪(Column Pruning)等,通过这些规则优化查询执行路径。
- 谓词下推:减少数据处理量的关键 谓词下推是RBO的重要规则,它将过滤条件尽可能下移到数据扫描阶段,在源数据读取时就过滤掉无关记录,从而减少后续计算的数据量,降低重复计算代价。
- 常量折叠:简化表达式的高效方式 常量折叠通过在查询解析阶段预先计算常量表达式的值(如1+1+i.iid中的1+1可直接计算为2),避免在执行阶段重复计算,优化查询效率,是RBO中基于经验制定的常用规则。
- 列裁剪: 与临时表或者派生表的优化有关,就是将冗余的列进行消除,只保留需要用到的临时表中的列,以减少空间使用,提升效率。
RBO虽成熟且覆盖大部分查询场景,但优化过程中不感知表的底层存储形式和实际数据量等物理特征,因此在复杂场景下可能无法生成最优执行计划,需结合其他优化方式。
基于成本的优化CBO
基于成本的优化(CBO)通过计算所有可能物理计划的代价,选择代价最小的执行方案。其核心在于评估给定物理执行计划的总体代价。
- 总代价的构成:节点代价之和 物理执行计划为树状结构,总代价等于每个执行节点的代价之和。每个节点代价包含两部分:该节点对数据集的影响(输出数据集大小与分布),以及该节点操作算子的代价。
- 算子代价:基于规则的固定描述 每个操作算子的代价相对固定,可通过预定义规则描述。例如,全表扫描、索引扫描、哈希连接等算子,其CPU、I/O开销有标准计算方式。
- 数据集估算:统计信息与推算结合 初始数据集(原始表)的大小与分布通过统计信息获得;中间节点输出数据集的大小与分布,则由输入数据集信息和操作本身特点推算得出。
CBO(基于成本的优化器)依赖准确的统计信息生成最优执行计划,包括表的行数、数据分布、列的基数、数据宽度等,这些信息是计算物理执行计划代价的基础。数据分布估算包括初始数据集大小与分布(通过统计信息直接获得),以及中间节点输出数据集的大小与分布(根据输入数据集信息和操作算子特点推算)。
GBase 8s通过自动收集和手动更新两种方式获取统计信息。自动收集在数据变化达到阈值时触发,手动可通过ANALYZE命令更新,确保优化器及时掌握数据最新状态。统计信息过时或缺失会导致CBO对数据分布估算偏差,可能选择低效执行路径,如错误预估返回行数导致全表扫描代替索引扫描,显著降低查询性能。
索引扫描方式与性能影响分析
顺序扫描
顺序扫描是数据库服务器按照物理顺序逐行读取表中所有记录的扫描方式。常发生在表上无可用索引、数据量很少或者无法使用索引的SQL语句中,例如未建立索引的大表简单查询或全表统计。
索引扫描
索引扫描通过先读取索引页,获取数据行的ROWID,再根据ROWID回表查询对应数据记录。适用于等值查询或范围查询等场景,能有效减少扫描的数据量,提升查询效率。 索引扫描主要分为键值扫描与键有限扫描等。
- 键值扫描Key-only Index Scan: 键值扫描(Key-only Index Scan)是指当查询所需的所有数据列都包含在索引节点中时,数据库服务器只需读取索引,无需回表查询数据页。例如执行"SELECT c1 FROM ti WHERE c1 = 125" 时,若c1上建有索引且查询仅需c1列,则触发键值扫描。键值扫描通过避免访问表数据页,显著减少I/O操作,提升查询效率。尤其适用于仅需查询索引覆盖列的场景,如统计分析、简单过滤查询等,可有效降低磁盘访问开销。
- 键优先扫描Key-first Index Scan: 键优先扫描(Key-first Index Scan)是一种索引扫描方式,它首先使用索引键过滤器减少查询读取的数据量。可通过Hint强制使用,例如"select /*+INDEX(tl index_tl_c12) */ * from tl where (c1> 0) and (c2 =1000 or c2=55667)",优化器会优先根据索引键过滤数据。
键值扫描适用于查询列全为索引覆盖列的场景;键优先扫描适用于多条件过滤且索引键能有效缩减数据范围的场景。通过执行计划分析索引使用情况,可针对性选择扫描方式以优化性能。
索引还有一种使用方法就是索引反转:
当SQL语句中存在降序排序操作时,数据库会自动反转默认升序的索引,以避免额外的排序开销,适用于需要按索引列降序查询的场景。例如执行SELECT c1 FROM tiORDER BY c1 DESC;时,GBase 8s会自动反转索引,利用索引结构完成降序排列,减少排序操作。
两种扫描方式的性能对比与选择策略
顺序扫描由于需扫描全表,在数据量大时性能较差,但对小表或无索引表简单查询可能更高效; 索引扫描可快速定位数据,适合大表查询,但需维护索引结构,会增加写入操作开销。 优化器会根据表大小、索引情况等自动选择合适扫描方式。
性能调优实践策略与方法
索引优化
覆盖索引:减少回表开销的核心策略 覆盖索引包含查询所需的所有列,可直接从索引获取数据,避免回表访问表数据,显著降低I/O操作。 例如,查询customer_id和order_date时,创建包含这两列的索引可实现key-only扫描。
复合索引:多字段查询的优化利器
复合索引需根据查询条件顺序创建,遵循"最左前缀匹配"原则。
如对orders表的customer_id和order_date字段创建复合索引,可加速WHERE customer_id=?AND order_date>?类查询,优化器能高效利用索引定位数据。
索引虽提升查询性能,但会增加DML操作(INSERT/UPDATE/DELETE)的维护成本。需根据业务查询频度与数据变更频率,合理规划索引数量与字段组合,优先保障核心查询路径的索引覆盖。
参数调优
数据库有多种配置参数,例如HASHMAP_PAGE_NUM参数用于控制GBase 8s数据库哈希连接、哈希分组等操作时可使用的页数量。适当增加该参数可减少磁盘临时文件的使用,提升查询性能,尤其适用于内存充足的场景。
统计信息更新
优化器依赖准确的统计信息生成最优执行计划。统计信息包括表数据量、列值分布等,若信息过时,可能导致优化器选择低效的索引或连接方式。 应定期更新统计信息,可通过自动调度任务或手动执行UPDATE STATISTICS命令实现。对于数据频繁变更的表,建议增加更新频率,确保优化器获取最新数据特征。
典型案例分析
SQL语句如下:
select org_code,itmno,exc_date,balamt,tenant_id,unit
from kpi_etl_dept_time
where exc_date >= to_date(?,'yyyy-MM-dd') and exc_date <= to_date(?, 'yyyy-MM-dd') and itmno in (?,?,?)
order by exc_date asc, itmno asc;
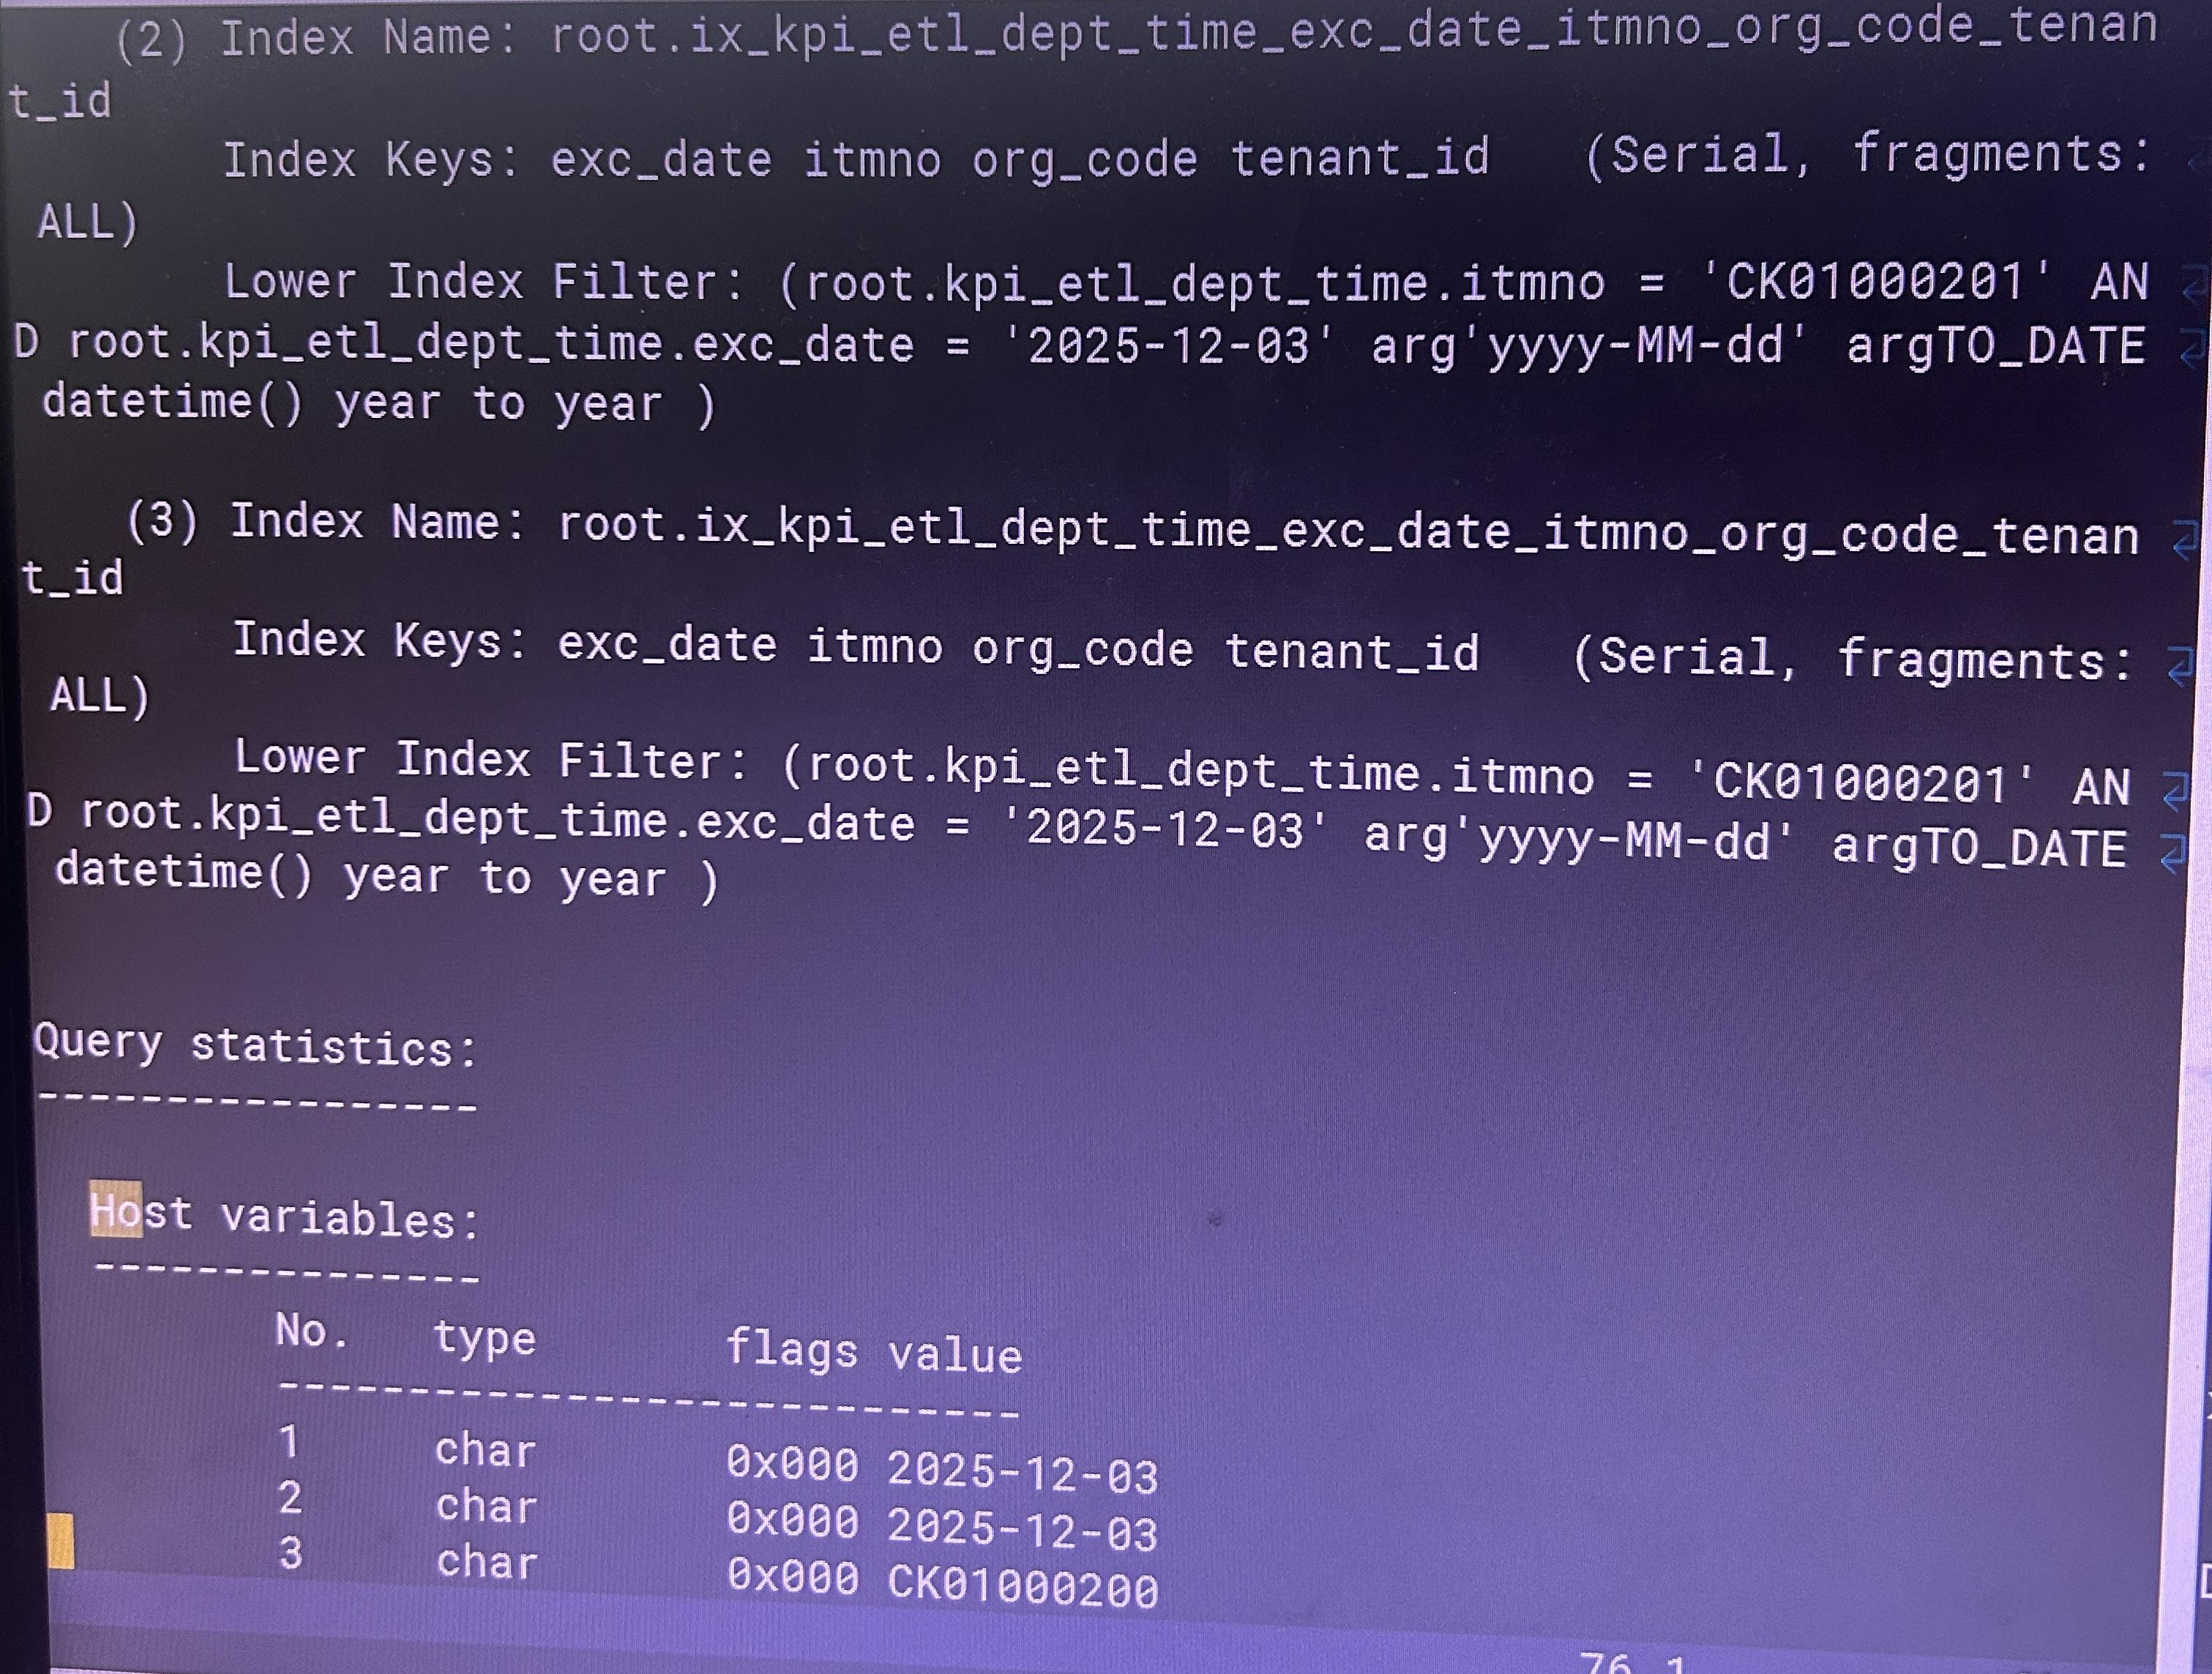
执行计划如下:
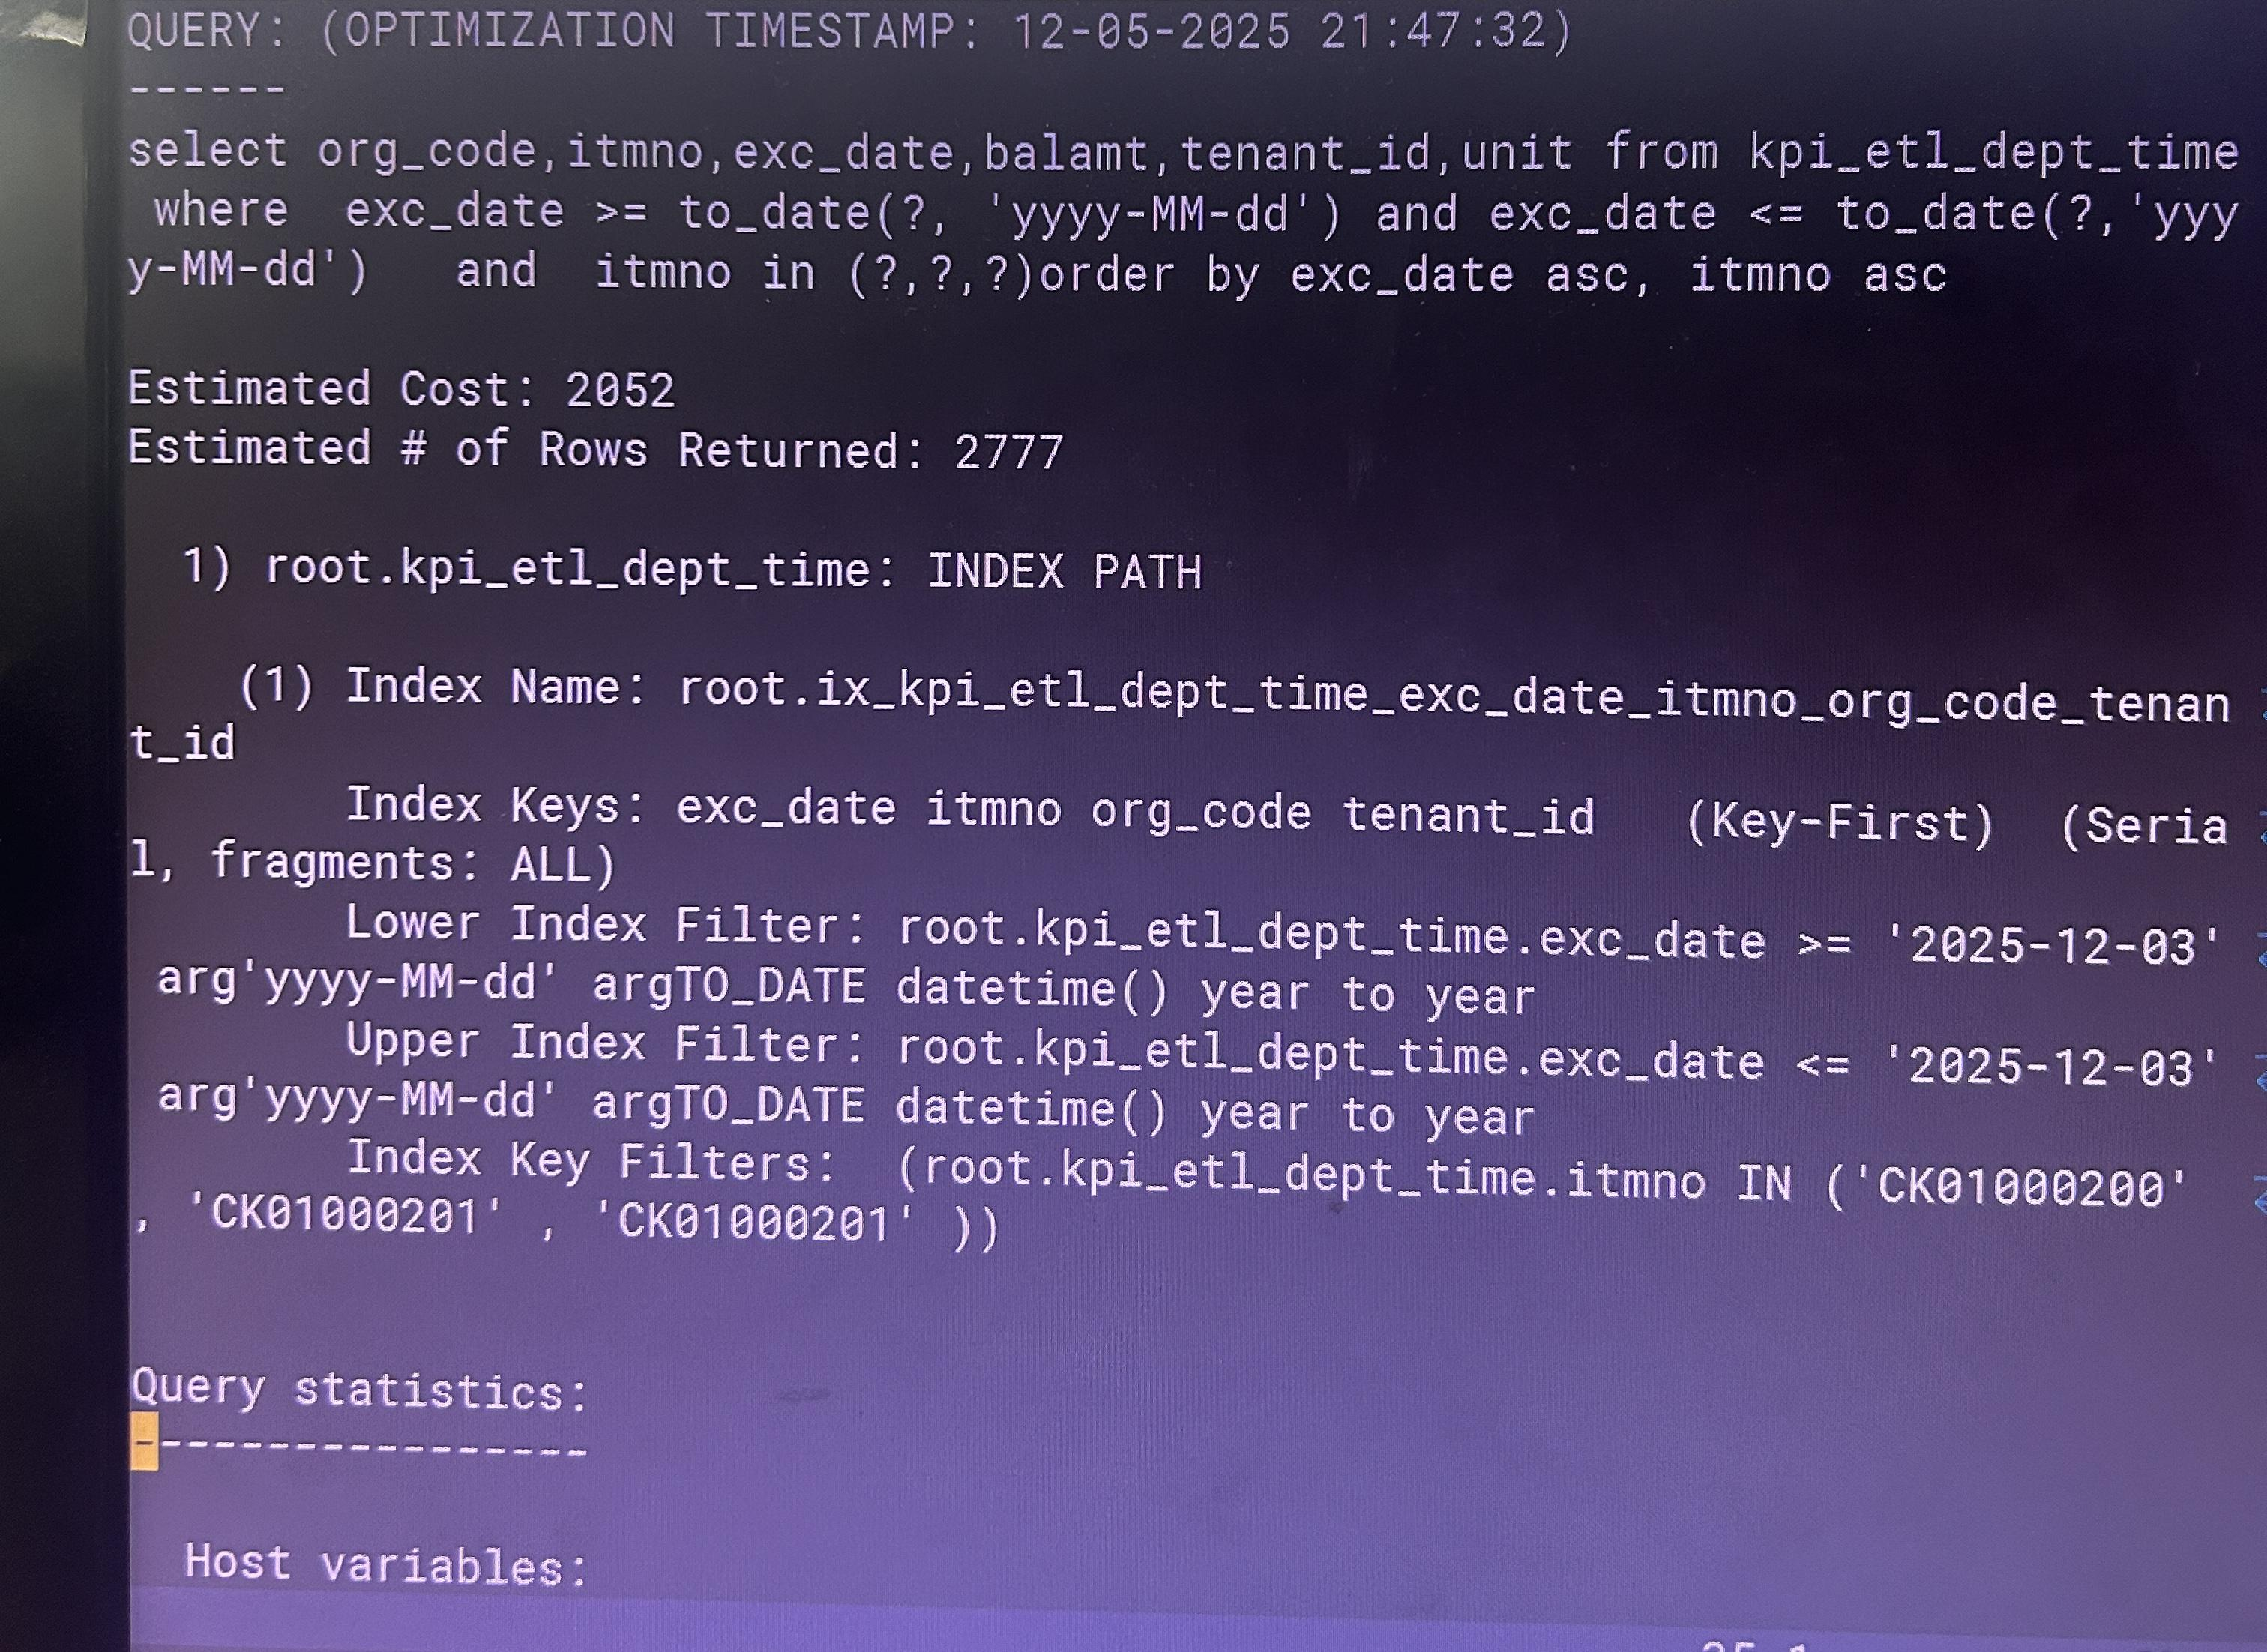
问题现象: 某业务查询执行耗时超过百秒,通过EXPLAIN分析发现执行计划中对过滤器中索引选择的偏移,未使用预期的索引过滤器。表数据量60万行,索引过滤器选择了选择性高的并且使用函数计算的过滤器使用索引,计算开销巨大。 从上图执行计划中可以看到,先进行了时间列的过滤,再进行了in条件的过滤,但是满足时间要求的数据太多了,如果可以先进行in条件的过滤,将大大减少后续操作的数据量;还有一个问题就是to_date函数使用了绑定变量,在优化器阶段并没有将绑定变量进行常量折叠计算。
根因分析:
- to_date函数大量重复计算。
- 过滤器选择索引选择了选择性大的过滤器优先使用索引过滤。
优化措施:
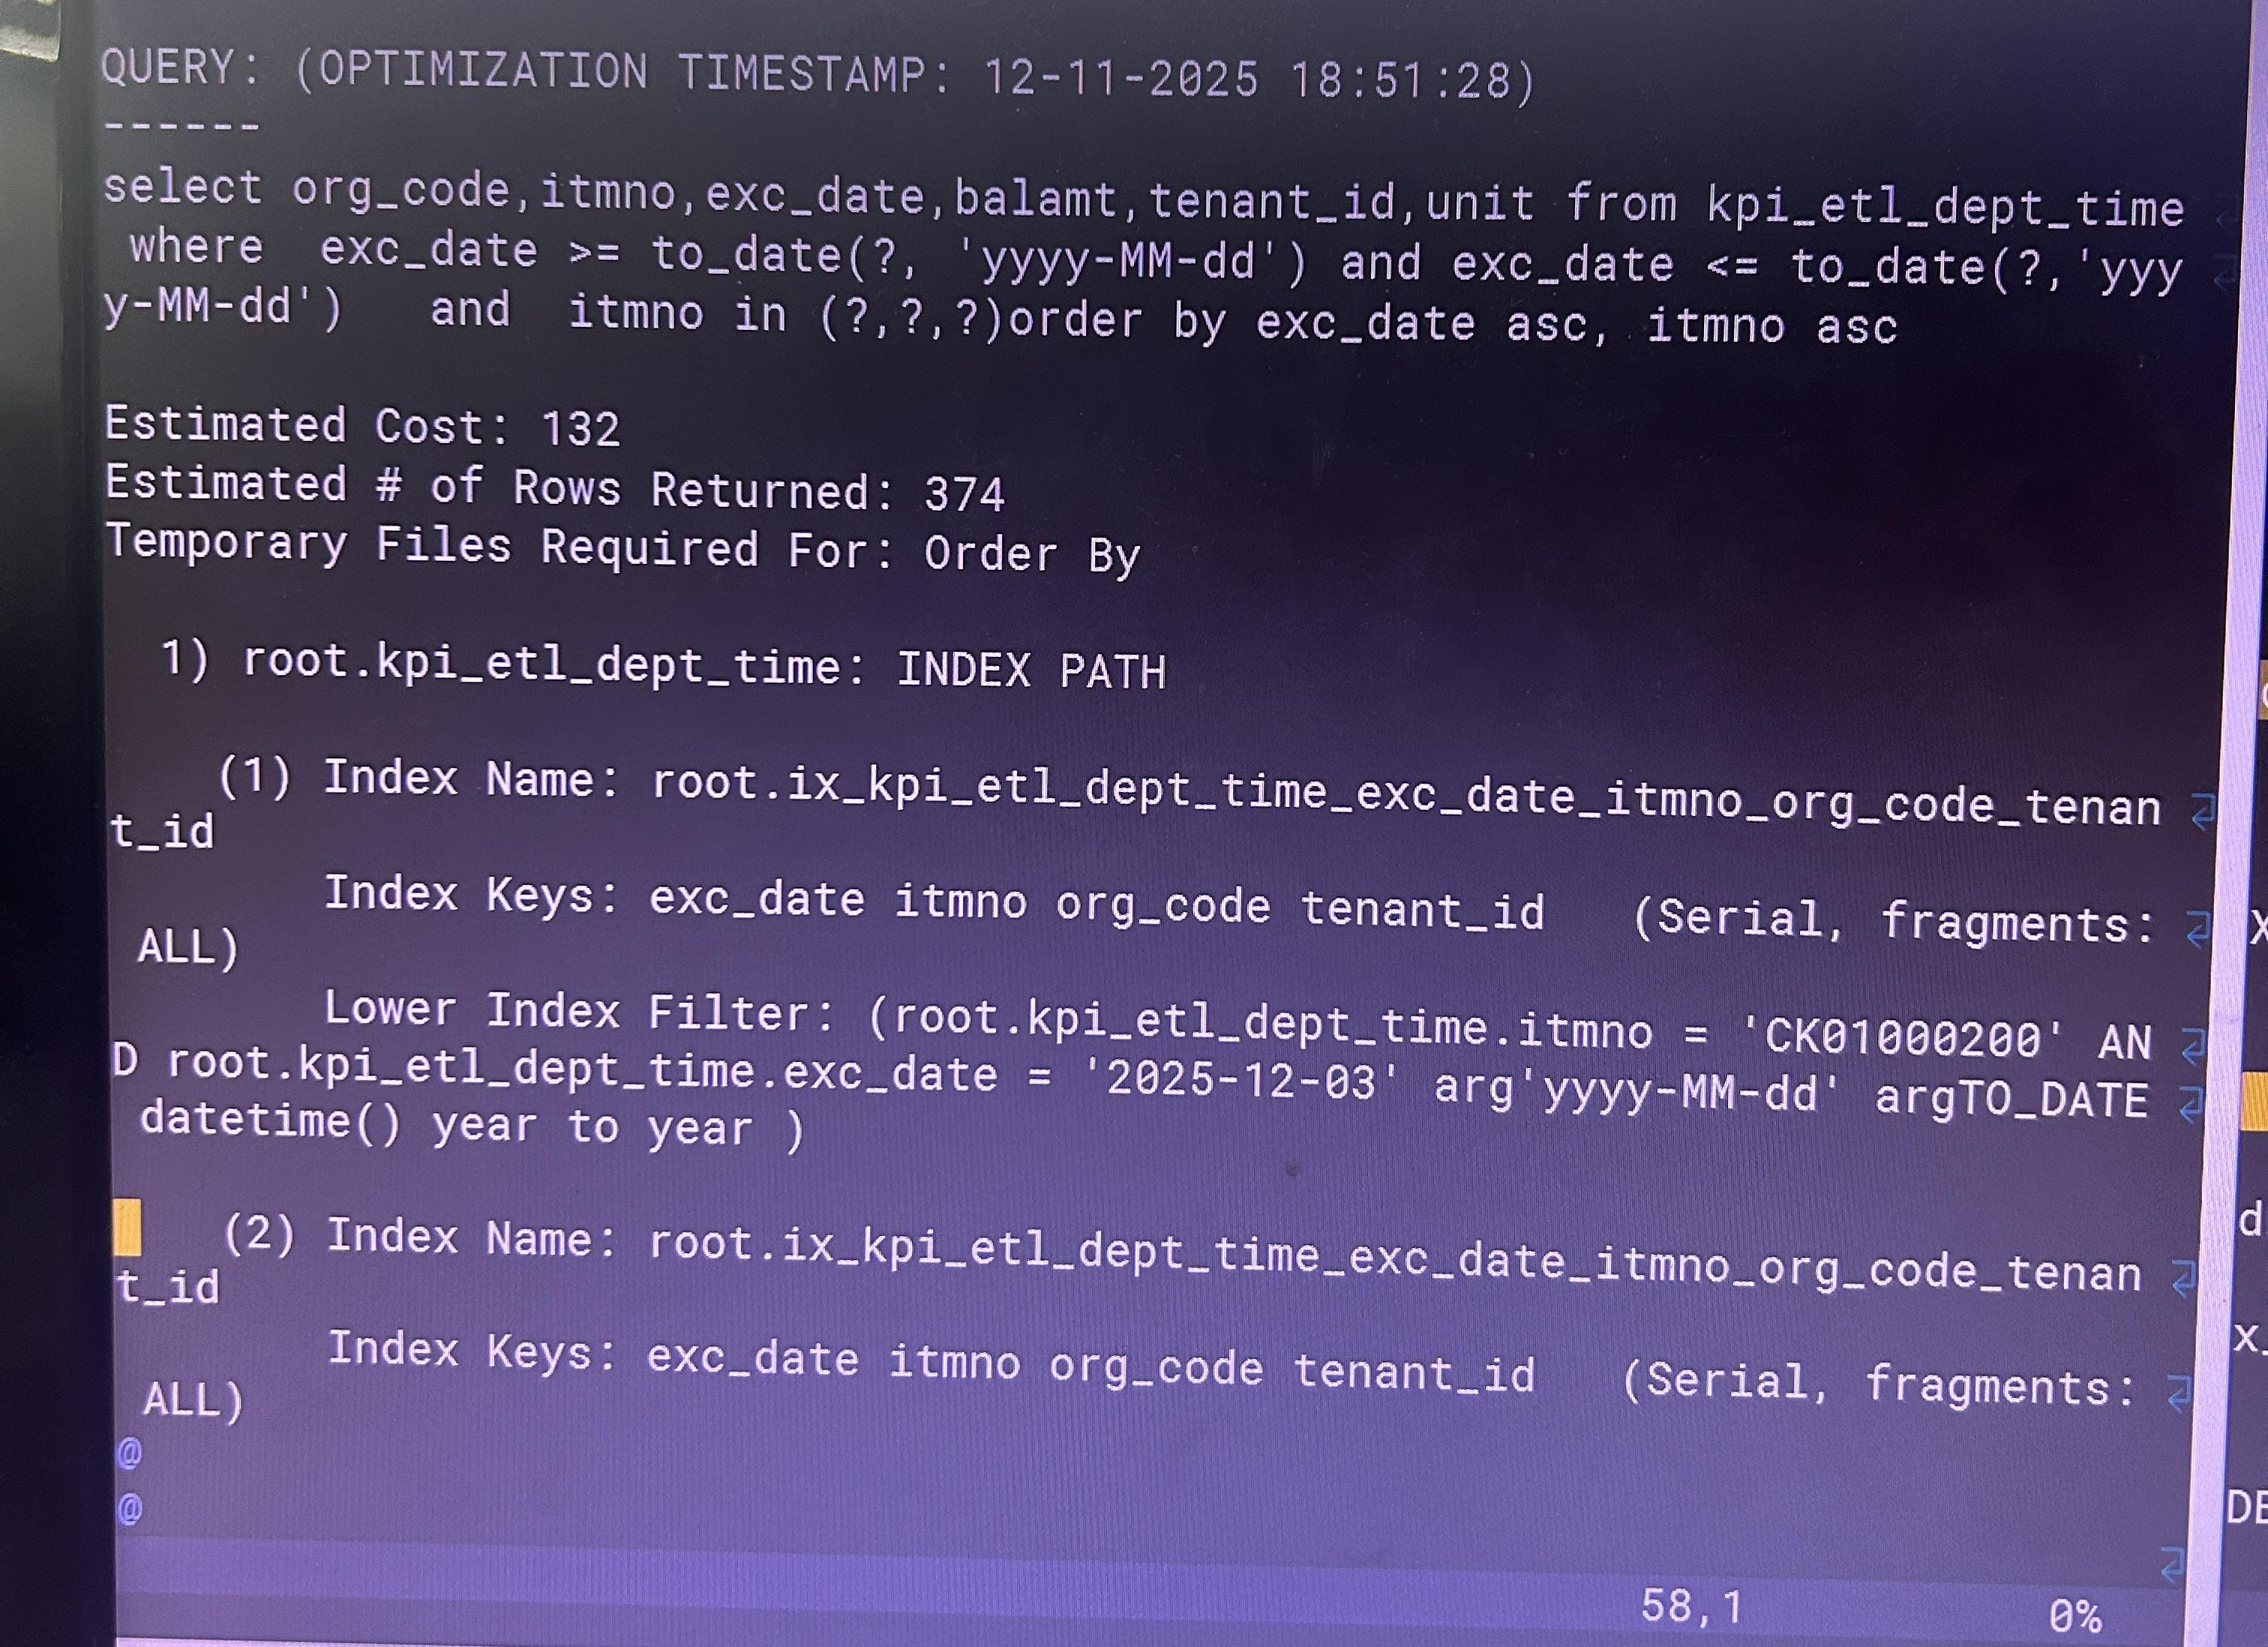
- 新建索引使的选择性小的过滤器优先使用索引,即把复合索引中in条件所在的列调整为第一个,满足左前匹配原则,先进性in条件的过滤。
- 进行专项优化,使含有绑定变量的常量函数提前进行计算。
优化效果:
自测60万行数据测试,执行时间十几秒左右,优化后达到秒级。
参考视频
【G 术时刻第 20 期】GBase 8s 执行计划解析与性能调优实践 P1-背景介绍_哔哩哔哩_bilibili
【G 术时刻第 20 期】GBase 8s 执行计划解析与性能调优实践 P2-执行计划生成与配置_哔哩哔哩_bilibili
【G 术时刻第 20 期】GBase 8s 执行计划解析与性能调优实践 P3-执行计划核心组成要素_哔哩哔哩_bilibili
【G 术时刻第 20 期】GBase 8s 执行计划解析与性能调优实践 P4-优化器原理 RBO 与 CBO_哔哩哔哩_bilibili
【G 术时刻第 20 期】GBase 8s 执行计划解析与性能调优实践 P5-索引扫描方式与性能影响分析_哔哩哔哩_bilibili
【G 术时刻第 20 期】GBase 8s 执行计划解析与性能调优实践 P6-性能调优实践策略与方法_哔哩哔哩_bilibili
评论
热门帖子
- 12025-12-01浏览数:183621
- 22023-05-09浏览数:26315
- 42023-09-25浏览数:19987
- 52020-05-11浏览数:18690