GBase 8c Oracle 增量数据同步——数据库同步工具设计与实现详解
一、技术背景
同步架构
GBase 8c 的数据同步能力基于 Flink CDC 框架实现,目标是将其他数据库的变更操作实时同步到 GBase。
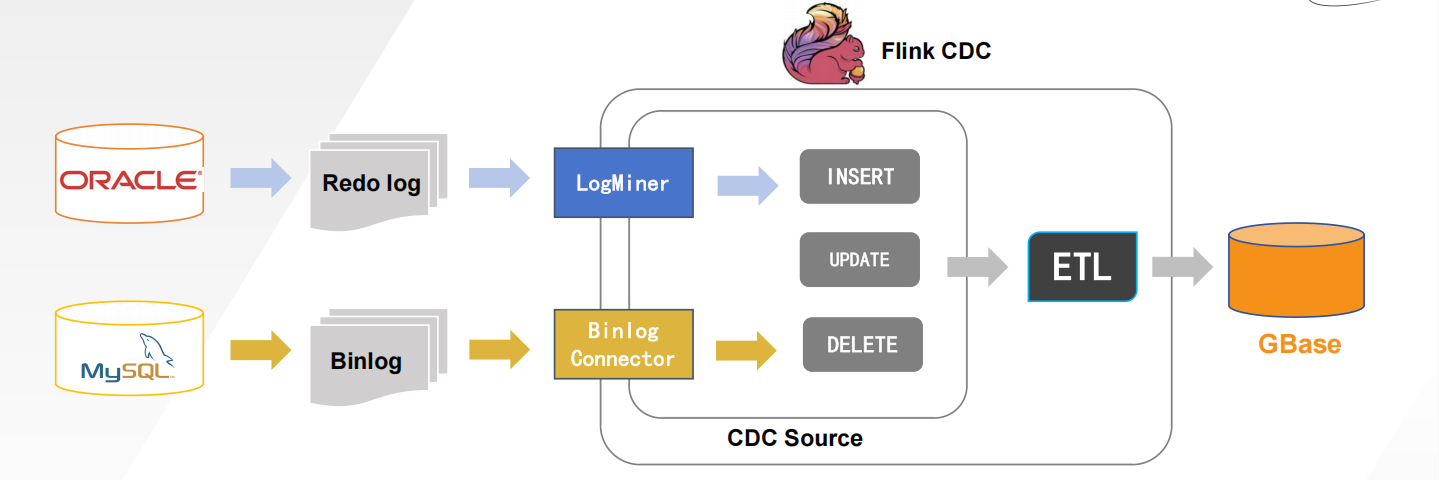
整体架构分为 Source 端和 Sink 端:
- Source 端:读取源端数据库的日志文件,捕获变更操作(INSERT、UPDATE、DELETE)。Oracle 读取 Redo Log,MySQL 读取 Binlog。
- Sink 端:对变更数据做加工转换处理,包括模式名及表名映射、字段类型转换等,然后拼接成标准 SQL 语句在 GBase 数据库中执行。
什么是 Flink CDC
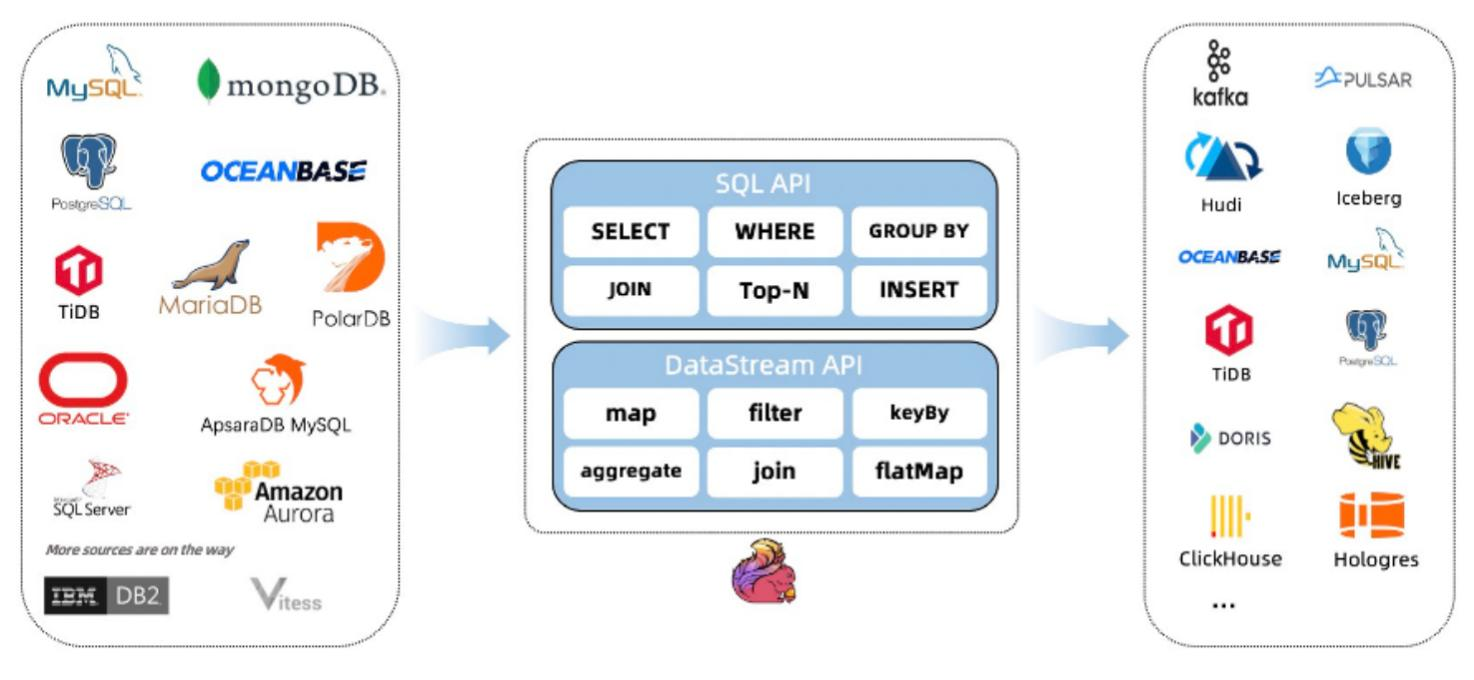
Flink CDC 是基于 Apache Flink 和 Debezium 构建的一套实时数据同步框架。它以一种非常简单、稳定的方式,把数据库的变更事件(CDC)实时同步到 Flink 任务中,从而让数据库本身变成实时数据源。
为什么选择 Flink CDC
| 特性 | 说明 |
|---|---|
| 端到端数据集成框架 | 提供全量和增量的一体化同步,支持多种源端和目标端 |
| Schema Evolution | 可捕获原表结构变更,并同步至下游系统 |
| Exactly Once | 确保在发生故障时,数据的一致性和准确性 |
| Streaming Pipeline | 以流的方式处理数据,提供毫秒级延迟 |
| Full Database Sync | 支持整库同步,通过配置可捕获所有表数据变更 |
Flink CDC 如何捕获变更
数据库变化捕获(CDC)的策略主要包括两种:
**定期查询(Query-based CDC)**:通过周期性地直接查询数据库来探测变化。此方法简单但受限于查询频率与延迟,难以满足实时性要求,且对数据库压力较大。
**基于日志的实时处理(Log-based CDC)**——推荐方式:利用数据库自带的日志机制(如 MySQL 的 Binlog、Oracle 的 Redo Log)来捕捉变更。该方式通过监听并解析这些连续更新的日志流,能够在数据更改发生时几乎无延迟地捕获到变化,无需频繁查询数据库本身。此过程不仅减轻了数据库压力,而且由于日志的顺序性和完备性,能确保每个变更事件精确地被消费一次,实现"精确一次"的处理语义,保障了数据处理的一致性和可靠性。
Debezium 连接器
Debezium 是一个构建在 Apache Kafka 之上的 CDC 开源平台。它的主要用途是在事务日志中记录提交给每个源数据库表的所有行级更改。侦听这些事件的每个应用程序都可以根据增量数据更改执行所需的操作,既支持全量同步也支持增量同步。
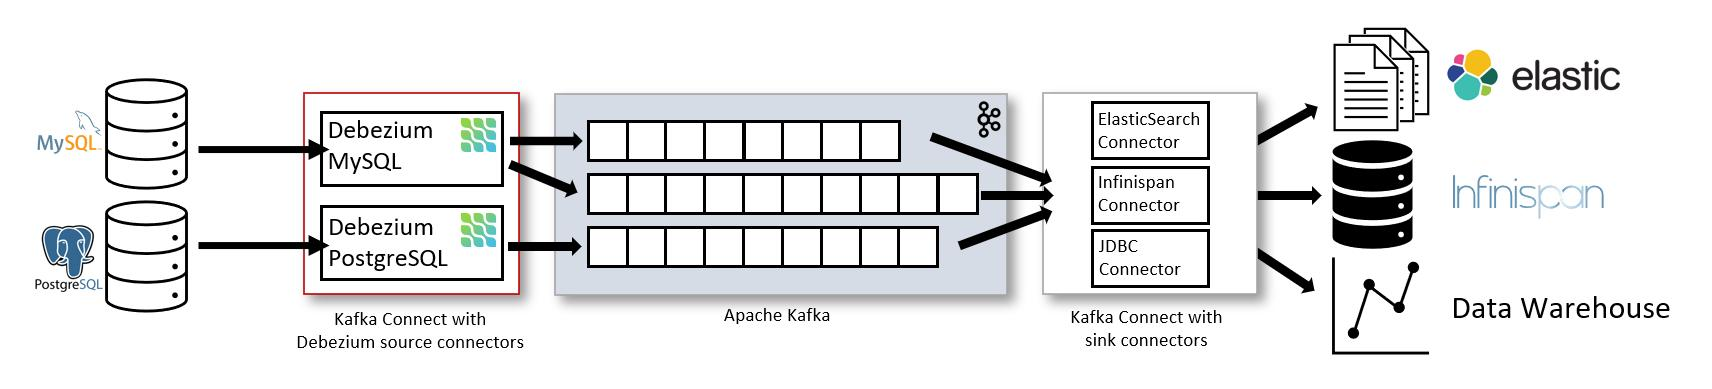
Debezium 提供了一个连接器,支持多种数据库,例如 MySQL、Oracle、PostgreSQL 等。这些连接器可以监视和记录数据库更改并将其发布到 Kafka 等流服务。
启动方式有三种:
| 部署方式 | 说明 |
|---|---|
| 构建在 Kafka Connect 上 | 依赖 Kafka Connect 运行时 |
| 部署 Debezium Server | 独立部署服务 |
| 程序内嵌 Debezium 引擎 | Flink CDC 选择集成此方式 |
二、核心原理
Oracle 日志解析方案对比
业界解析 Oracle 日志的常见方案:
| 方案 | 费用 | 说明 |
|---|---|---|
| LogMiner | 免费 | Oracle 官方提供的日志分析工具,运行在 Oracle 数据库上,通过解析 Redo/Archived Logs 得到数据变更事件。是目前开源工具集成使用最多的方案 |
| XStream | 收费(License 限制) | Oracle 官方提供的组件和接口,可以从客户端读取事件变更 |
| OGG | 收费 | Oracle 官方提供的日志解析工具,兼容性和性能好 |
| 第三方裸日志解析 | 免费 | 逆向工程,反解 Oracle 日志,实现难度大,准确性难以保证 |
GBase 8c 的选择
GBase 8c 采用 LogMiner 方案——免费、开源、社区活跃,是当前最成熟的选择。
LogMiner 日志解析步骤
LogMiner 解析 Oracle Redo Log 分为五步:
第一步:构建数据字典
Oracle 的 Redo Log 并非为 CDC 场景设计,而是用于数据库崩溃时的恢复。因此日志中记录的是物理日志而非逻辑 SQL,需要先创建数据字典,将物理日志映射为可读的逻辑日志。
-- 构建数据字典
dbms_logmnr_d.build(
    dictionary_filename => 'dictionary.ora',
    dictionary_location => '/home/oracle/LOGMNR'
);
第二步:添加解析日志文件
指定要解析的 Redo Log 文件。
-- 添加日志文件
dbms_logmnr.add_logfile(
    logfilename => '/home/oracle/app/oracle/oradata/helowin/redo01.log',
    options => dbms_logmnr.NEW
);
第三步:开始解析日志
-- 启动 LogMiner
dbms_logmnr.start_logmnr(
    dictfilename => '/home/oracle/LOGMNR/dictionary.ora'
);
第四步:查询增量日志
解析出的逻辑日志会被放入 V$LOGMNR_CONTENTS 视图中,可根据 SCN(System Change Number)查询所需的解析结果。
-- 查询增量日志
select * from v$logmnr_contents where scn > ? and scn < ?
第五步:解析查询结果
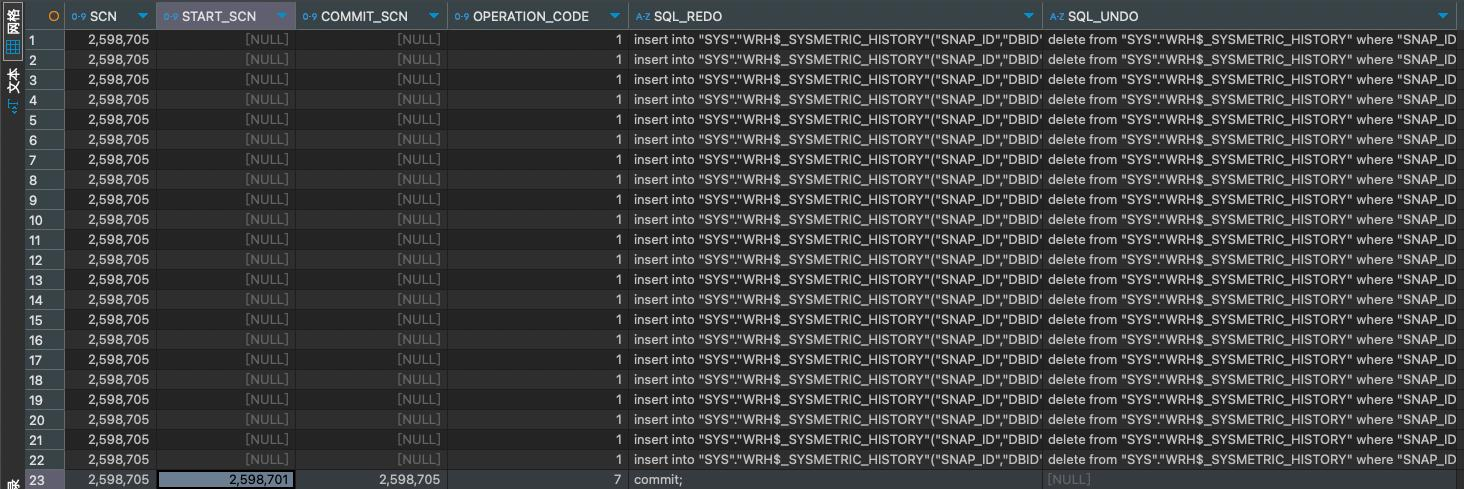
查询结果中的关键字段:
| 字段 | 说明 |
|---|---|
| SCN | 日志位点,标志日志的顺序,通过 SCN 确定 SQL 执行的先后顺序 |
| Operation Code | 操作代码(INSERT / UPDATE / DELETE 等) |
| SQL Redo | 解析出的逻辑 SQL 语句 |
| SQL Undo | Redo 的反向操作。如果执行了 DML 但未提交并回滚,则执行 Undo 将数据恢复到操作之前的状态 |
Oracle 同步流程——全量快照阶段
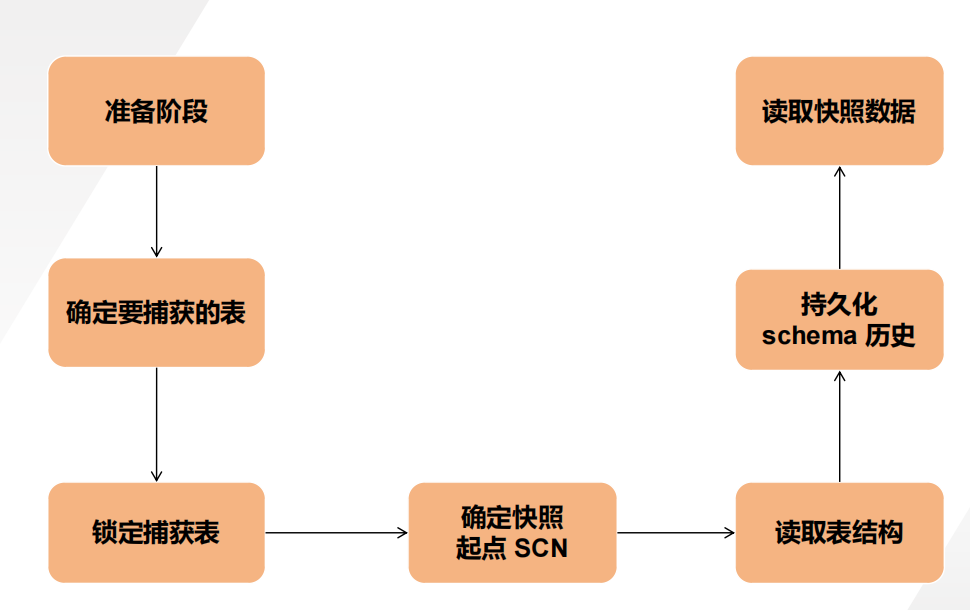
CDC 在初始化时并非直接读取日志,而是需要先确定一个起始点。全量快照阶段的流程:
- 准备阶段:确定要捕获的表
- 锁定捕获表:保证快照一致性
- 确定快照起始 SCN:标记同步的起点
- 读取表结构:持久化 Schema 历史
- 读取快照数据:将当前数据完整迁移到目标端
在该起始 SCN 之前的数据做全量迁移,之后的所有变更才属于增量同步。确定起始 SCN 是非常关键的一步——CDC 需要一个明确的"分割点",在这个点上对所有表做一次完整快照,原封不动迁移过来,之后的增量数据才从这个点往后开始同步。
Oracle 同步流程——增量同步阶段
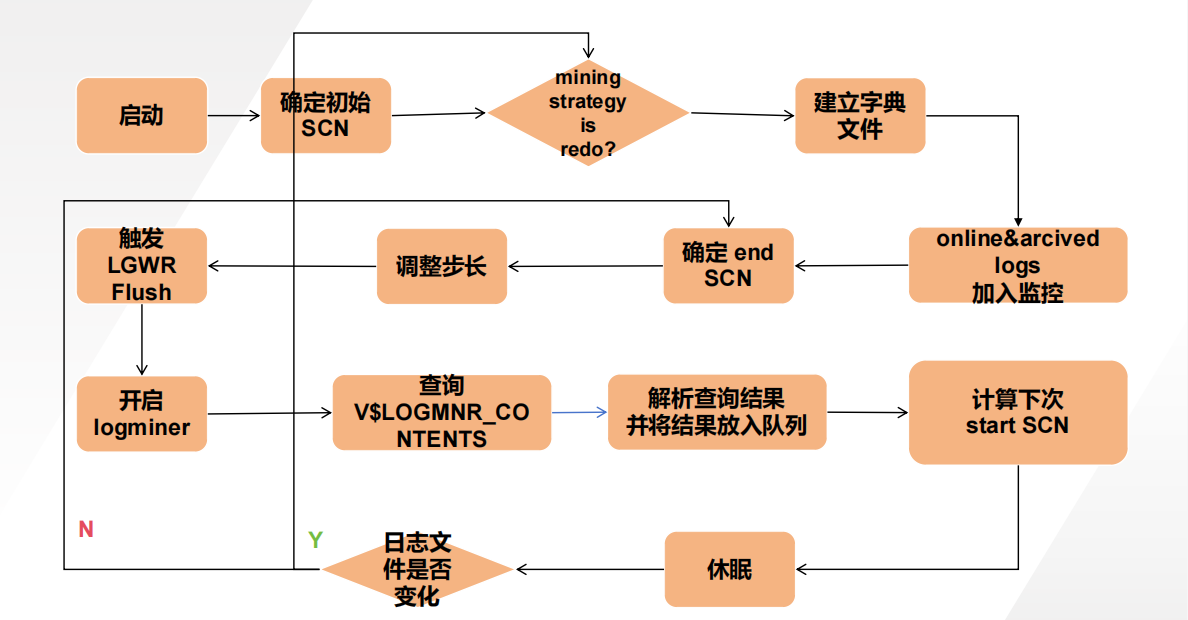
确定起始 SCN 后,进入增量同步的循环流程:
- 启动 → 确定初始化 SCN
- 判断日志类型:解析 online log 还是已落地的 Redo/Archived Log
- 若日志文件有变化 → 建立数据字典 → 将 online & archived logs 加入监控
- 若日志文件无变化(已在监控中)→ 跳过字典建立步骤
- 触发 LGWR Flush(将内存中的日志落地到磁盘)
- 确定 end SCN → 调整步长
- 开启 LogMiner → 查询
V$LOGMNR_CONTENTS获取逻辑 SQL - 解析查询结果并放入队列
- 计算下次 start SCN → 判断是否需要休眠 → 循环回到步骤 2
确定初始 SCN——Pending 问题
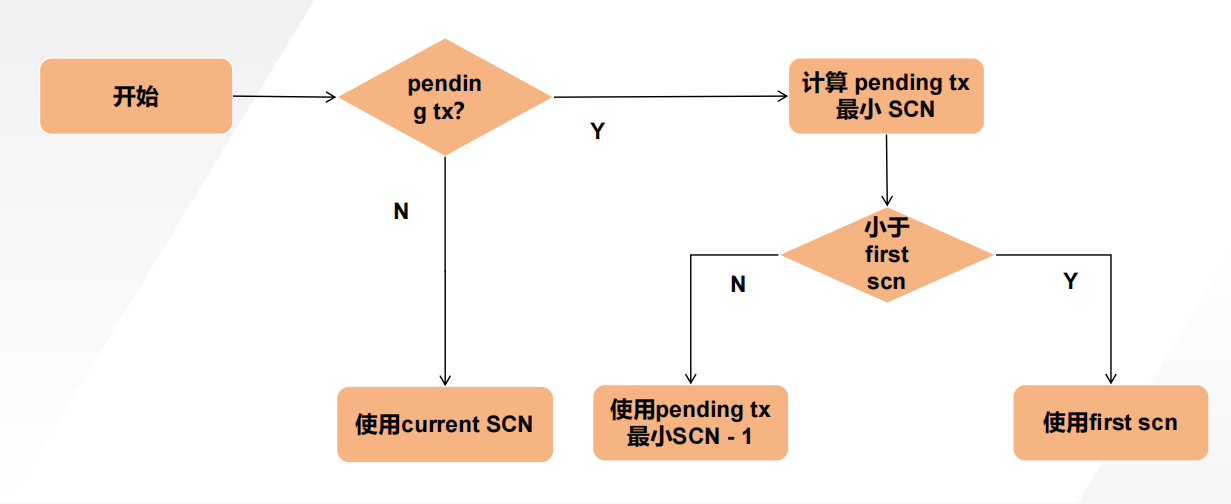
这是增量同步中最容易被忽视却最致命的问题。
场景举例:假设从 SCN=5 开始同步,但在 SCN=3 时有一个事务开始执行(INSERT/UPDATE),直到 SCN=6 才提交(COMMIT)。如果简单地从 SCN=5 开始,那么 SCN=3 和 SCN=4 的操作就会丢失。
判定逻辑如下:
- 检查是否存在 Pending TX(未提交的事务)
- 如果不存在 Pending TX → 直接使用当前设置的 SCN
- 如果存在 Pending TX → 计算 Pending TX 的最小 SCN
- 将该最小 SCN 与当前日志文件的 First SCN(最早 SCN)比较:
- 若 Pending TX 的 SCN 小于 First SCN → 说明该事务在更早的日志文件中,使用 First SCN(当前文件最早可解析的位置)
- 若 Pending TX 的 SCN 不小于 First SCN → 使用 Pending TX 最小 SCN - 1(确保该事务被完整捕获)
关键原则
不能因为追求"从某个精确点开始"而丢掉尚未提交的事务。Pending 保护机制确保了数据完整性。
计算 end SCN 与动态步长调整
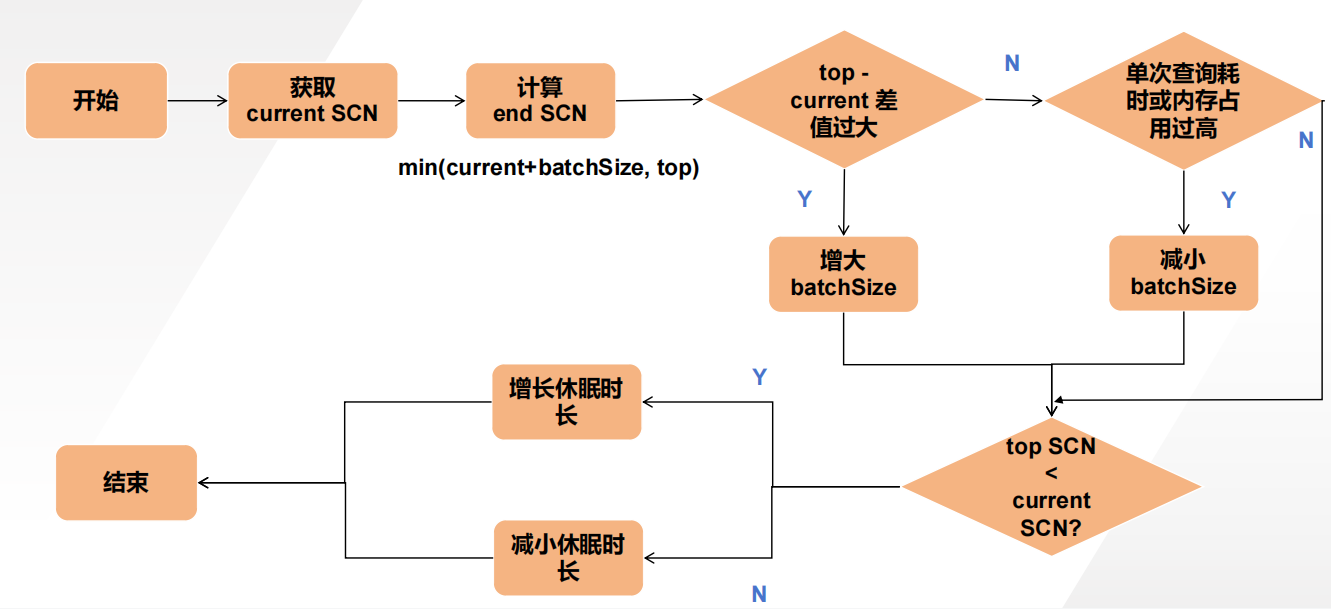
end SCN 计算:end SCN = min(current SCN + batchSize, top SCN)
其中 top SCN 是当前日志文件中最新的 SCN 位点。即使你设置的 batchSize 很大,如果日志只记录到某个位置,也不可能读到更远的数据。
步长动态调整策略:
Oracle 数据库存在明显的高峰期和低谷期,流量差异大。如果始终保持固定的 batch size,会导致高峰期同步跟不上、低谷期资源浪费。因此步长需要动态调整:
- 获取当前 SCN 和日志最新 SCN(top)
- 计算差值:
top - current SCN - 若差值过大(数据积压多)→ 增大 batchSize,加快追赶速度
- 若差值不大 → 判断单次查询耗时或内存占用是否过高:
- 若过高 → 减小 batchSize,降低数据库和内存压力
- 若正常 → 保持当前步长
- 同时调整休眠时长:
- 差值大(积压多)→ 减小休眠时长,加快查询频率
- 差值小(已追上)→ 增长休眠时长,降低对数据库的频繁访问
三、常见问题
问题一:SCN 计算异常导致同步性能差
现象:日志显示已开启同步,日志没有报错,但是没有任何 DML 事件进入到 SinkFunction。
排查过程:打开 debug 日志观察,发现 SCN 的差距比较大,一直在追赶。排查发现,有 pending 的事务 start SCN 为 0,导致计算 start SCN 从归档日志的最小 SCN 号开始,中间积压的数据量过大,始终追不上。
解决方案:通过忽略 start SCN 为 0 的事务来解决此类问题——与客户确认该事务的实际用途,确认无用后不再回溯到 SCN=0 的位置。
问题二:SCN 过旧(日志已被覆盖)
现象:报错 SCN 过旧,同步停止。典型报错信息:
None of log files contains offset SCN: 15639226799513, re-snapshot is required.
这种情况一般是同步性能追不上线上日志量,最终失败退出。
排查方向:
| 排查方向 | 可能原因 | 解决思路 |
|---|---|---|
| 目标端 | 没有任何索引,导致 UPDATE/DELETE 走全表扫描 | 为目标端表添加合适索引 |
| 目标端 | SCN 最大查询范围和步长配置过小 | 调整步长参数 |
| 源端 | V$LOGMNR_CONTENTS 查询性能差 | 优化查询或调整同步并发 |
| 源端 | Oracle 集群状态影响 LogMiner 解析速度 | 检查集群健康状态 |
四、DMT工具演示
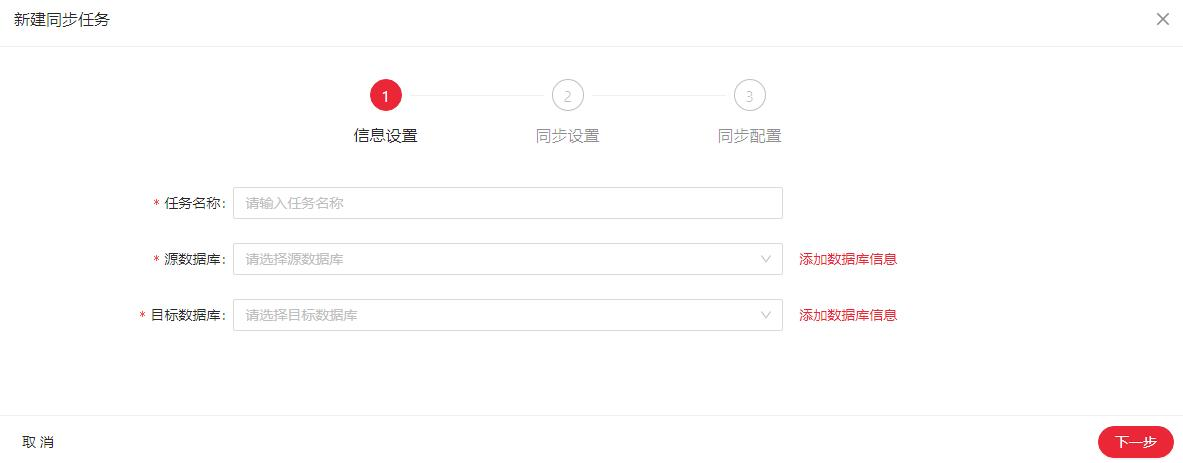
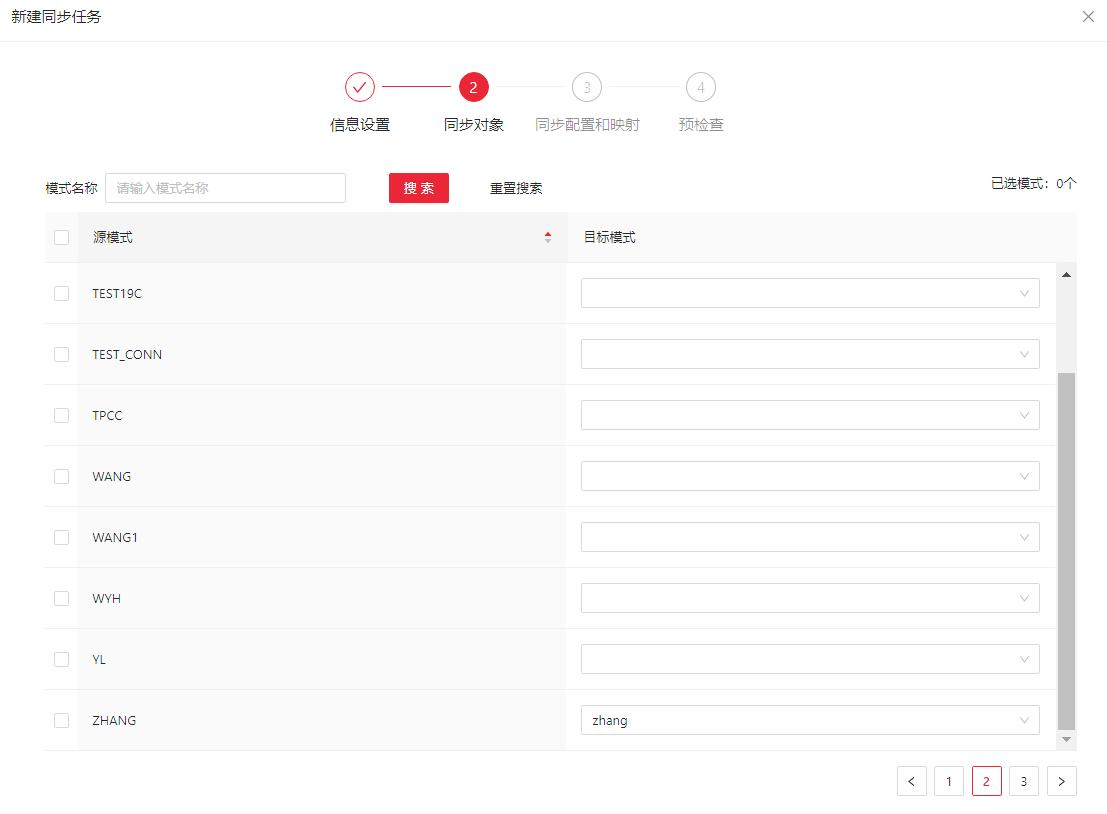
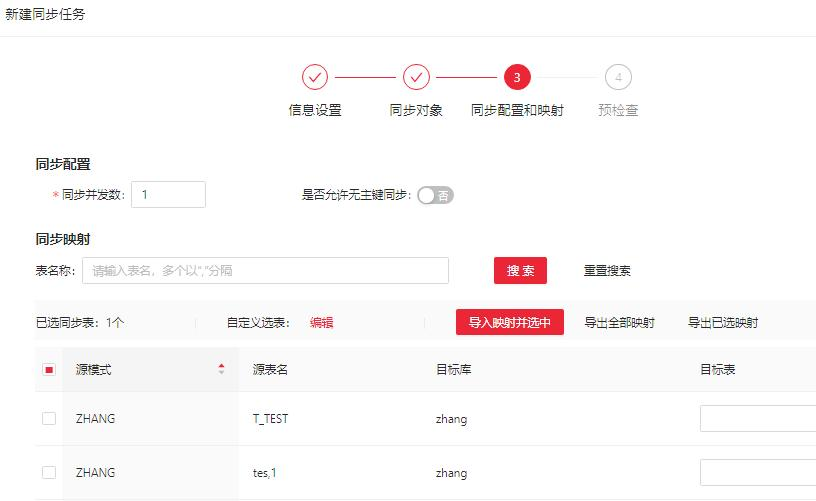
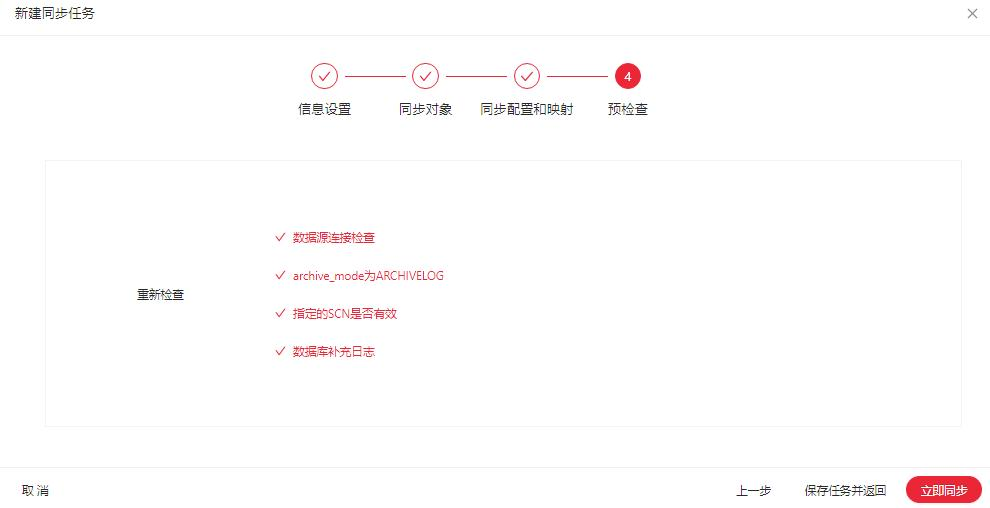
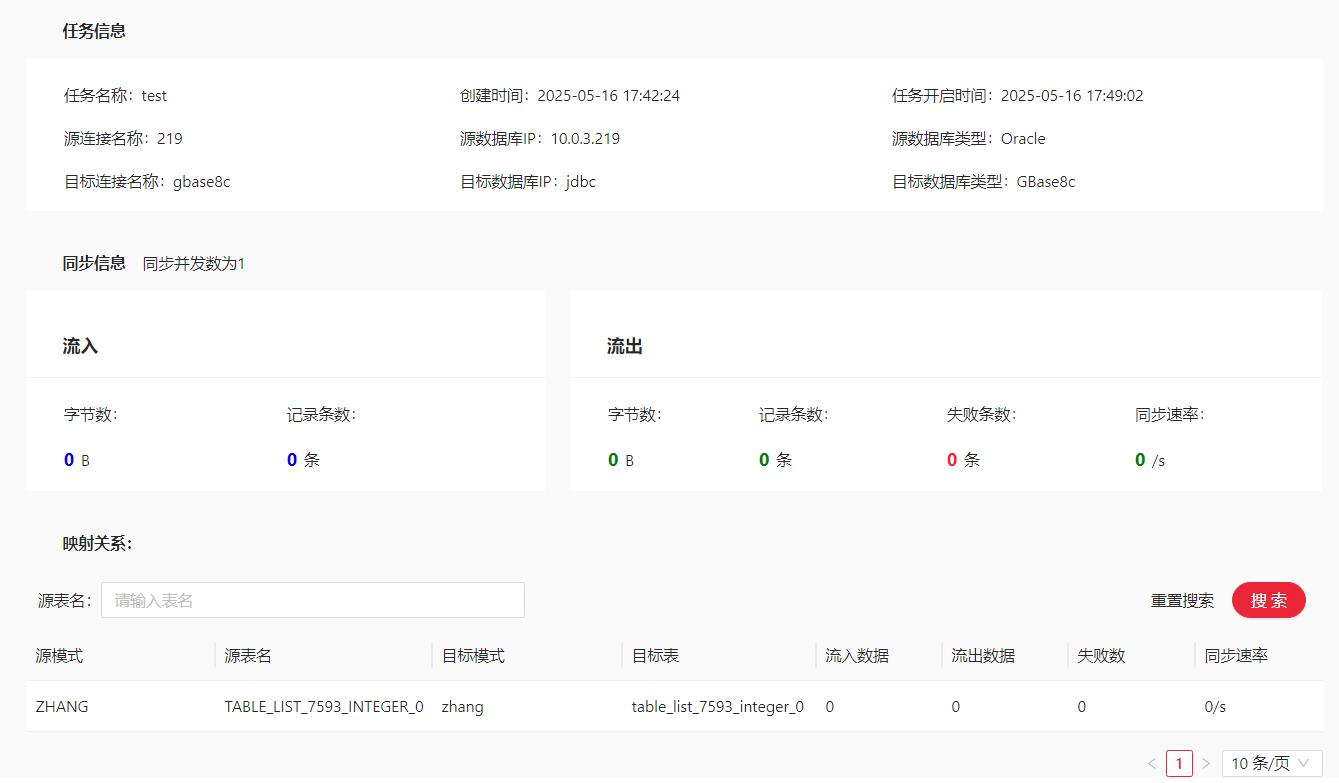
五、总结
GBase 8c 的 Oracle 数据增量同步方案,以 Flink CDC + Debezium + LogMiner 为核心技术栈,实现了:
- 日志驱动的实时同步 — 基于 Redo Log 解析,无需频繁查询数据库,对源端压力小
- 全量 + 增量一体化 — 先做全量快照建立基准,再持续同步增量变更
- 智能步长调整 — 动态适应数据库高峰期/低谷期,在追赶速度与系统负载间取得平衡
- Pending 事务保护 — 通过 SCN 判定确保未提交事务不丢失
一句话总结
Oracle 增量同步 = Flink CDC 框架 + LogMiner 日志解析 + 动态步长 + Pending 保护,实现从 Oracle 到 GBase 8c 的实时、可靠、低侵入数据同步。
六、参考视频
【G 术时刻第 23 期】GBase 8c Oracle 数据增量同步 P1-技术背景_哔哩哔哩_bilibili
【G 术时刻第 23 期】GBase 8c Oracle 数据增量同步 P2-核心原理_哔哩哔哩_bilibili
评论
热门帖子
- 12025-12-01浏览数:183700
- 22023-05-09浏览数:26397
- 42023-09-25浏览数:20060
- 52020-05-11浏览数:18785