GBase 8a的全文索引
一、全文索引-功能
① 支持表中所有文本类型字段的索引与查询 ② 在创建索引过程中可实现查询功能 新插入数据后,更新索引时,允许同时对已有数据进行查询功能 ③ 新追加数据可分批创建索引 手动通过UPDATE对新追加的数据 UPDATE INDEX index_name ON table_name
二、全文索引-查询案例
支持全文索引列的逻辑表达式查询 ① 可以结合AND、OR等逻辑运算符来构建复杂的查询条件 select * from t1 where contains(memo,'"TianJin"&"ltd"'); select * from t1 where contains(memo,'TianJin ltd'); select * from t1 where contains(memo,'"张三"|"TianJin"'); select * from t1 where contains(memo,'"张三"|"TianJin"-"人"'); ② NEAR函数:NEAR ((term1, term2), num[,Order]) term : 搜索词。多个之间用逗号分割。词之间是AND关系。且每个搜索词必须精确满足。 num : 表示词距数,非 0 整数,词距(包括匹配词),实际词距小于 num 值即为符号要求。 order : 表示词序。Order 为可选项,默认值为 0,表示无词序。 为 0 代表无词序 为 1 代表有词序。
三、索引建立、分词、搜索等过程可通过GBase 8a配置文件配置
配置文件所在位置:/opt/gbase/192.168.163.3/gcluster/server/lib/gbase/plugin/gbfti/cfg/
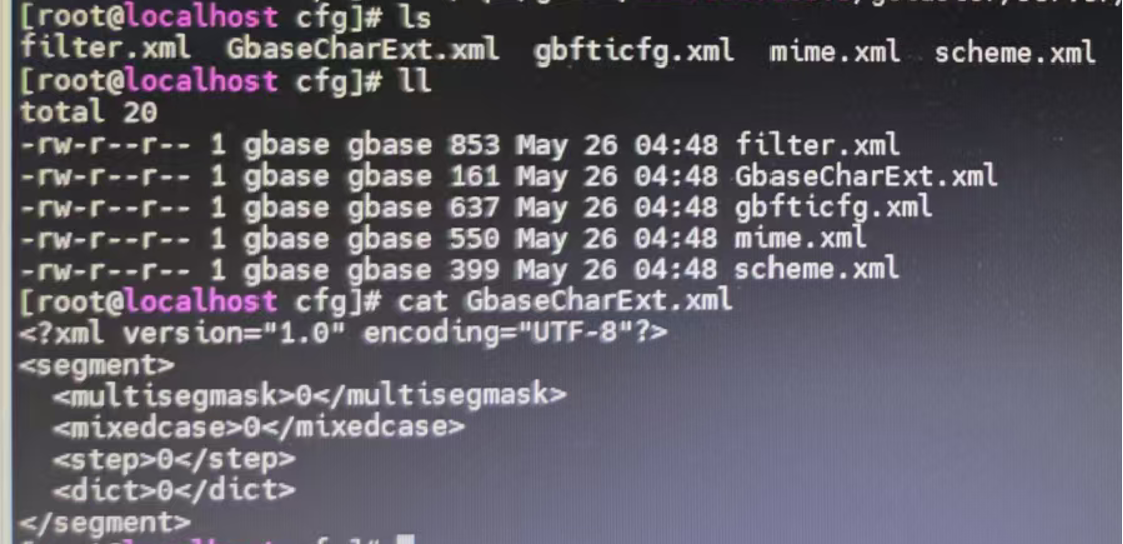 multisegmask 分词类型
0:自然分词;默认。
1:数字多元分词;
2:英文多元分词;
mixedcase 是否区分大小写
0:不区分;默认。
1:区分
step 分词步长
0:默认值,等同于3元分词。
大于0的为实际步长
最大127。
dict 是否使用字典
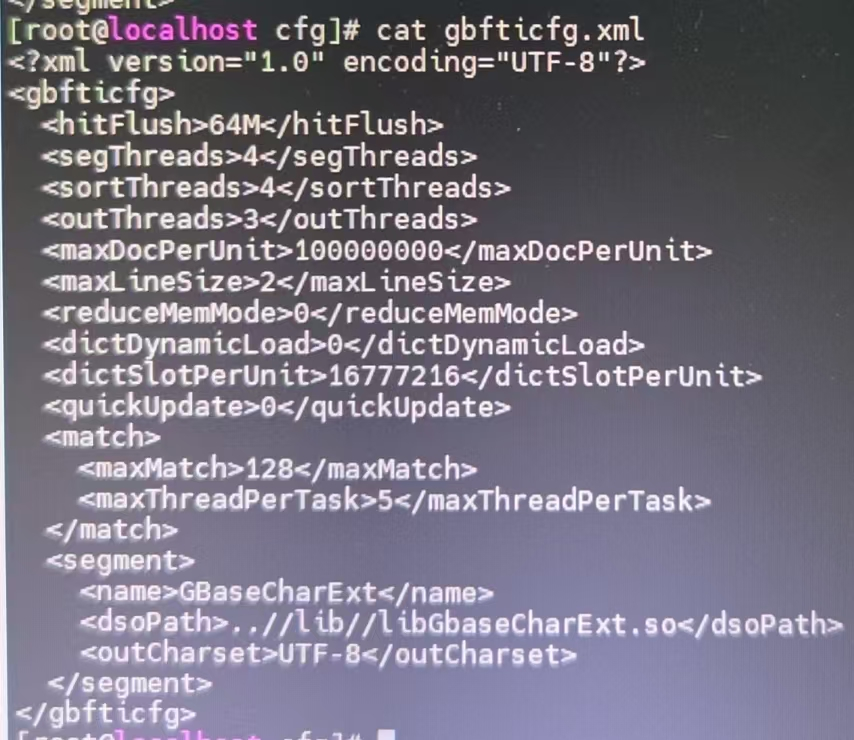 hitflush:单次分词任务最大能处理的大小
dictSlotPerUnit:字典哈希桶数,越大查单词越快,占内存也越高
quickUpdate:0 默认不快速更新,1 开启后多文件同时写数据,适合词典单词多、文档大的场景
segThreads:分词器数量
sortThreads:排序线程数量
outThreads:输出线程数量
maxDocPerUnit:单个字库最大行数
maxLineSize:单行最大文本数
reduceMemMode:0 默认让索引数据常驻内存,1 则不常驻(内存小时省空间,长耗时)。
dictDynamicLoad:字典数据动态加载
maxMatch:最大搜索并发数
maxThreadPerTask:最大搜索任务的并行度
dsoPath:分词器实现的动态库
outCharset:分词器输出的字符集
热门帖子
- 12025-12-01浏览数:183468
- 22023-05-09浏览数:26192
- 42023-09-25浏览数:19863
- 52020-05-11浏览数:18525